Il numero è 4551. Compare come WinError 4551 in coda a un traceback Python, e non significa niente per chiunque non abbia già passato un pomeriggio a cercarlo. Il codice sorgente non c’entra, la riga incriminata è un banale caricamento di libreria, e l’unica cosa che quel numero comunica davvero è che il sistema operativo ha guardato un file e ha deciso di non aprirlo. Non perché fosse rotto. Perché non lo conosceva.
Private Mind è una chat locale costruita attorno a un modello Gemma in formato GGUF, con backend Flask e un frontend HTML senza framework. La promessa è quella che sta attirando parecchie persone verso l’inferenza in casa propria, nessuna chiamata a un servizio remoto, nessuna chiave API, nessun testo che esce dalla macchina. L’obiettivo dichiarato dal primo giorno era arrivare a un pacchetto che si scarica, si scompatta e parte. La parte difficile, si scopre, non è far funzionare il modello. È far sì che funzioni su un computer che non è il tuo.
Il file che il sistema non riconosce
La configurazione di partenza puntava alle build CUDA di llama-cpp-python, quelle che scaricano l’accelerazione NVIDIA insieme al resto. Funzionano bene, quando funzionano. Il problema è la loro provenienza: non stanno sull’indice principale di PyPI, ma su un indice secondario pubblicato dal maintainer del progetto. Sono wheel legittime, mantenute da chi mantiene la libreria, e nessuno le ha mai messe in discussione. Ma non sono firmate, e i volumi di download sono di ordini di grandezza inferiori a quelli del pacchetto principale.
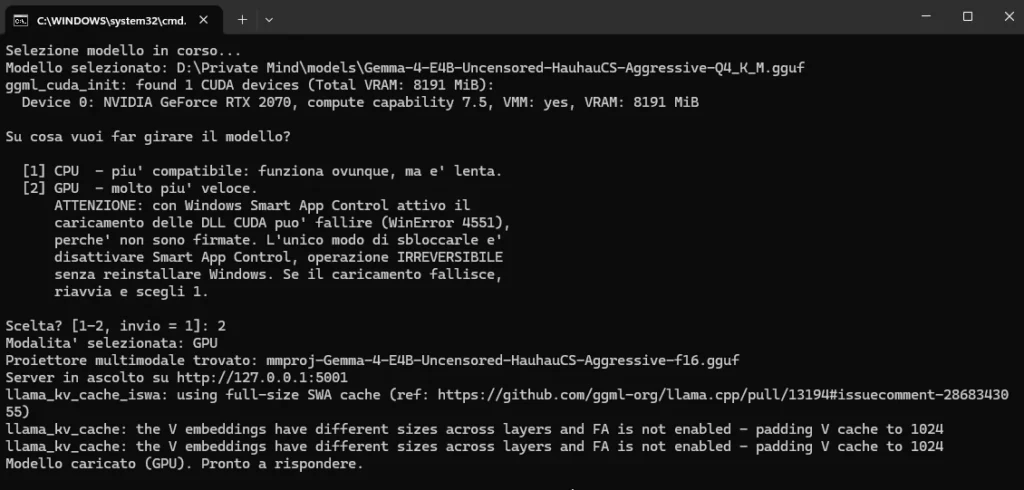
Smart App Control, il meccanismo introdotto nelle installazioni recenti di Windows 11, valuta i binari consultando un servizio di reputazione centralizzato. Non fa analisi statica del contenuto, non cerca firme di malware conosciuto: chiede se quel file è già stato visto girare abbastanza volte su abbastanza macchine senza combinare guai. Una DLL che nessuno ha mai scaricato non ha una risposta, e in assenza di risposta la decisione predefinita è il rifiuto. È così che ggml-cuda.dll non si carica.
La parte istruttiva è arrivata provando ad aggirarlo, perché ogni tentativo ha chiarito qualcosa. Caricare la stessa DLL da un secondo interprete Python, in un percorso completamente diverso, produce lo stesso errore identico: il blocco segue il file, non il percorso, non l’ambiente virtuale, non l’eseguibile che lo invoca. Questo chiude in un colpo solo l’intera categoria di soluzioni che un pacchetto portatile potrebbe offrire, perché un pacchetto portatile è esattamente questo, un file spostato in un’altra cartella. Non esistono liste di esclusione da compilare. Le regole basate sui firmatari vivono dentro una policy Microsoft che non consulta gli archivi di certificati installati sulla macchina, quindi firmare le librerie con un certificato proprio non produce alcun effetto. E disattivare del tutto il meccanismo è un’operazione a senso unico, si spegne, non si riaccende, se non reinstallando il sistema.
Vale la pena essere precisi su cosa questo sia e cosa non sia. Non è una manovra contro gli sviluppatori indipendenti, ed è una difesa che intercetta una classe reale di attacchi, quelli che consegnano codice mai visto prima su macchine che non hanno modo di valutarlo. Il costo, però, ricade tutto su chi distribuisce software poco diffuso, e ricade in modo asimmetrico, chi ha volume passa, chi non ce l’ha aspetta.
Una libreria identica, due esiti a tre giorni di distanza
L’osservazione che ha spostato la decisione è arrivata quasi per caso. Il 4 agosto veniva bloccata anche ggml-base.dll, cioè la libreria della build CPU, quella che con CUDA non c’entra niente. Il 7 agosto la stessa identica copia, stesso file, stesso percorso, stesso byte per byte, veniva caricata senza una parola. Nel frattempo non era cambiato nulla sulla macchina e nulla nel file. Era cambiato il mondo attorno, abbastanza persone avevano scaricato quel wheel da PyPI perché il servizio di reputazione avesse un’opinione.
C’è qualcosa di scomodo in questo, e conviene guardarlo bene invece di scansarlo. Il software non viene giudicato per quello che fa. Viene giudicato per quanto è conosciuto. Sono due criteri diversi che nella maggior parte dei casi coincidono, perché il codice diffuso è anche il codice che qualcuno ha esaminato, ma non coincidono sempre e soprattutto non coincidono all’inizio. Ogni progetto nuovo attraversa una finestra in cui è indistinguibile da una minaccia, non per ciò che contiene ma per la sua novità. La reputazione, in pratica, è diventata un pezzo di infrastruttura al pari di un certificato o di un repository, con la differenza che non la si può acquistare né richiedere… si accumula, e mentre si accumula il software semplicemente non parte.
Questo spiega anche perché la scelta CPU non è un ripiego travestito da principio. L’indice CPU è praticabile per la stessa ragione per cui quello CUDA non lo è: le librerie arrivano dal pacchetto principale, quello che scaricano tutti. Non è che siano più sicure. Sono più conosciute.
Il conto da pagare
Passare tutto sulla CPU costa, e il pezzo di onestà che un progetto del genere deve a chi lo usa è quantificarlo invece di girarci attorno. La generazione di token con un modello quantizzato non è limitata dalla potenza di calcolo ma dalla banda di memoria, perché per ogni singolo token vanno riletti tutti i pesi attivi. Su una configurazione DDR4-2133 in dual channel si parla di circa 34 GB/s teorici. Una scheda video di fascia media sta attorno ai 448. Il rapporto è quello, e nessuna ottimizzazione del codice applicativo lo tocca minimamente.
Poi sparisce il requisito di avere una GPU NVIDIA, quello di avere i driver giusti, quello di avere la versione CUDA compatibile. Sparisce soprattutto la modalità di guasto peggiore che il pacchetto poteva avere, cioè l’applicazione che muore all’avvio su una macchina senza scheda dedicata con un messaggio incomprensibile per chi lo legge. E lo zip si alleggerisce parecchio, perché le librerie cuBLAS non vengono al seguito, la stima è attorno ai 60 MB, che per qualcosa che contiene un interprete Python completo non è male.
PyInstaller lasciato per strada
La pulizia ha investito anche il modo in cui il pacchetto verrà costruito, e qui la decisione è stata di rinunciare a uno strumento che era nei piani dall’inizio, rinunciamo a PyInstaller. Le estensioni compilate sono due, lxml (che arriva al seguito della lettura dei documenti Word) e llama-cpp stessa. Le librerie native di quest’ultima non sono moduli Python, quindi l’analizzatore statico non le vede e vanno dichiarate a mano una per una, sbagliare una riga produce un eseguibile che parte regolarmente e muore al caricamento del modello. Ogni modifica, anche di una singola riga, richiede una ricostruzione completa. E quando qualcosa non va sulla macchina di destinazione non c’è un file di testo da aprire e leggere, c’è un binario. In cambio di tutto questo, il vantaggio classico dello strumento (l’eseguibile unico) non era comunque raggiungibile, perché i 6 GB del modello restano fuori dal pacchetto in qualsiasi scenario.
L’alternativa scelta è il Python embeddable distribuito da python.org, una decina di megabyte, autocontenuto, senza percorsi assoluti scritti dentro. La versione è vincolata alla stessa dei wheel precompilati, perché le estensioni compilate sono legate alla minor version dell’interprete e un disallineamento produce un pacchetto che parte e si rompe dopo. Il vantaggio vero è che il codice resta leggibile, se qualcosa non va, sul computer di chi lo ha ricevuto c’è un file di testo da aprire.
Una regola secca accompagna tutto questo, ed è nata da un errore reale, il pacchetto si costruisce da zero, mai copiando l’ambiente di sviluppo. La ragione è che l’ambiente di sviluppo era andato alla deriva rispetto a quello dichiarato, con dipendenze installate in un posto e cercate in un altro, e la discrepanza era rimasta invisibile. Un pacchetto costruito copiando quel materiale sarebbe stato incompleto in un modo che nessuno avrebbe notato finché qualcuno non allegava un documento.
Cosa non è cambiato, e la strada che resta
La parte meno spettacolare del lavoro è anche quella che dice di più. Verificando come il codice calcola i percorsi delle cartelle, è emerso che con l’interprete embeddable l’applicazione non risulta “congelata”, quindi i rami che gestivano il caso PyInstaller semplicemente non vengono percorsi, e le cartelle dei modelli, degli agenti e dei dati finiscono al posto giusto senza toccare una riga. Le modifiche vere sono state altrove: la riga di configurazione che indicava CUDA mentre l’ambiente installato era CPU, una discrepanza che è rimasta lì per giorni senza produrre errori visibili, e i commenti che dichiaravano come piano una strada che non si sarebbe più percorsa. Un commento sbagliato non rompe niente e costa comunque, perché la prossima persona che legge quel file (spesso sei tu, tre settimane dopo) prende la sua decisione basandosi su quello.
Resta aperta una via per tornare sull’accelerazione, ed è WSL2. I binari in formato ELF non passano dal controllo di integrità di Windows, quindi l’intero problema di reputazione descritto fin qui non si presenta, e il codice non richiederebbe modifiche perché tutti i percorsi sono già gestiti in modo indipendente dal sistema. Il prezzo è che non sarebbe più un pacchetto portatile perché chi lo riceve dovrebbe installare e configurare un sottosistema Linux, cioè esattamente il tipo di operazione che il progetto sta cercando di eliminare.
Per ora ci fermiamo qui, è vero che la versione CPU è più compatibile ma veramente troppo, tropo lenta per un ambiente di sviluppo e se decidessi di disabilitare Smart App Control avremo comunque l’antivirus come scudo, anche se a un livello differente… delibero che decideremo in fase successiva.
Una svolta improvvisa
Il seguito è arrivato senza preavviso. Un controllo successivo, sulla stessa macchina e con le stesse librerie CUDA che prima si rifiutavano di caricare, è andato a buon fine, nessun errore, il dispositivo riconosciuto, l’accelerazione disponibile. La reputazione della libreria è appena cambiata, in meglio! Quindi ci rimane solo da portare la wheel CUDA dentro il venv, così avvia.bat darà entrambe le scelte e resteremo sull’ambiente pinnato. È un comando solo da avviare qualunque sia la posizione della console:
& "D:\Private Mind\venv\Scripts\python.exe" -m pip install --force-reinstall llama-cpp-python==0.3.34 --extra-index-url https://abetlen.github.io/llama-cpp-python/whl/cu124A questo punto avremo disponibile una scelta CPU/GPU da PowerShell. Lasciamo l’avviso su Smart App Control se dovesse ricapitare il WinError 4551, non si sa mai…
Se l’articolo ti è piaciuto restiamo in contatto su linkedin a: https://www.linkedin.com/in/andreatonin/
inferenzalocale #smartappcontrol #reputazionedelsoftware #cpuvsgpu #bandadimemoria #packagingpython #pyinstaller #pythonembeddable #sceltaarutime #fallimentivisibili

| Editorial Manager at Pills for Nerds | CTO & Technology Consultant |
Technology professional, editor and lifelong nerd with over 30 years of experience in the digital and innovation sectors. I work as a CTO and technology consultant, designing complex and scalable software ecosystems, and I am also active in IT education and professional training. Alongside my technology career, I serve as Editorial Manager and contributor at Pills for Nerds, online publication covering video games, game development, emerging technologies, artificial intelligence, digital culture and industry events. In my editorial role, I coordinate content planning and contribute articles, interviews, event reports and in-depth features. You can learn more about my consulting work at lucedigitale.com and connect with me on LinkedIn

 By