Quando abbiamo iniziato a lavorare su un assistente desktop locale con notifiche di Windows, ci siamo posti una domanda che suona semplice ma scava profondo: può un modello di linguaggio non solo generare testo, ma creare dati strutturati che il codice poi esegue? La risposta è sì, ma il percorso da “ricordami fra due minuti di chiamare il dentista” a un promemoria salvato su disco rivela come la vera intelligenza non sia tutta nel modello, a volte è nel vincolo che gli metti intorno.
L’idea: un agente che comanda
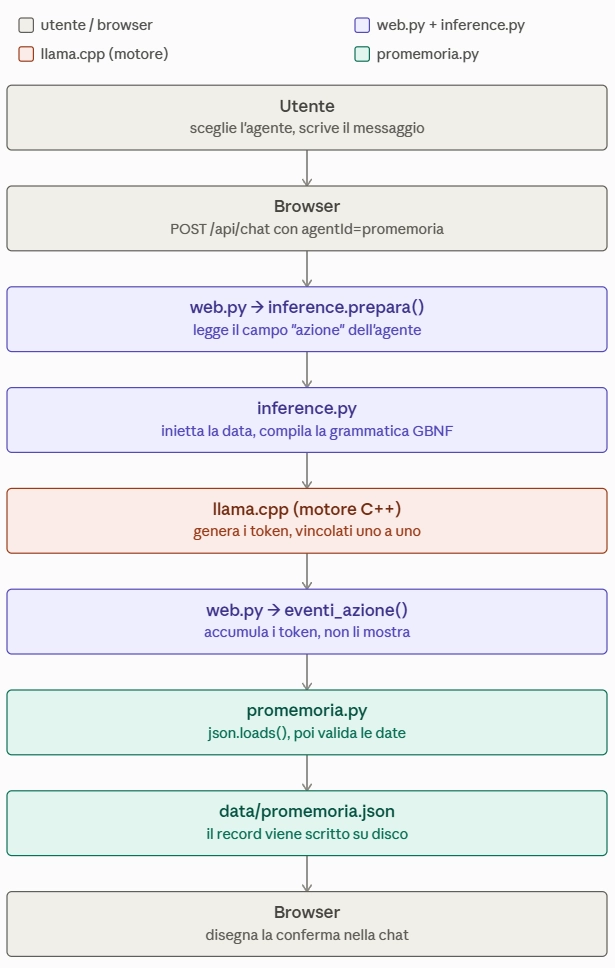
Fino a quel momento, tutto il flusso era unidirezionale: utente → modello → testo → mostra a schermo. Ma che succede se inverti il flusso? Utente → modello → comando strutturato → il computer lo esegue. Nasce l’agente “Promemoria”: quando lo scegli, non stai chiedendo al modello di raccontarti una storia, gli stai chiedendo di produrre un JSON che il server interpreterà e salverà su disco. È la differenza tra “dimmi una barzelletta” e “dimmi i dati di un cliente nel formato che riesco a importare”.
Il problema? Un modello lasciato libero genera testo fluente. Racchiudilo in un vincolo di sintassi e inizia a fare strani errori. Ecco dove entra la grammatica.
La grammatica GBNF
GBNF sta per Generative Backus-Naur Form, suona accademico, ma è semplicemente una lista di regole su quale testo è “legale” e quale no. È come le regole della sintassi, ma scritte in un modo che un motore può capire durante la generazione, non dopo.
Immagina di dire a un LLM “dimmi sì o no”, probabilmente genererà “Sì” e basta. Ma che succede se aggiunge un preambolo inutile come “Beh, considerando tutto…” e poi “no”? Hai fallito perché il modello sa come scrivere italiano fluente, non come stare dentro vincoli stretti.
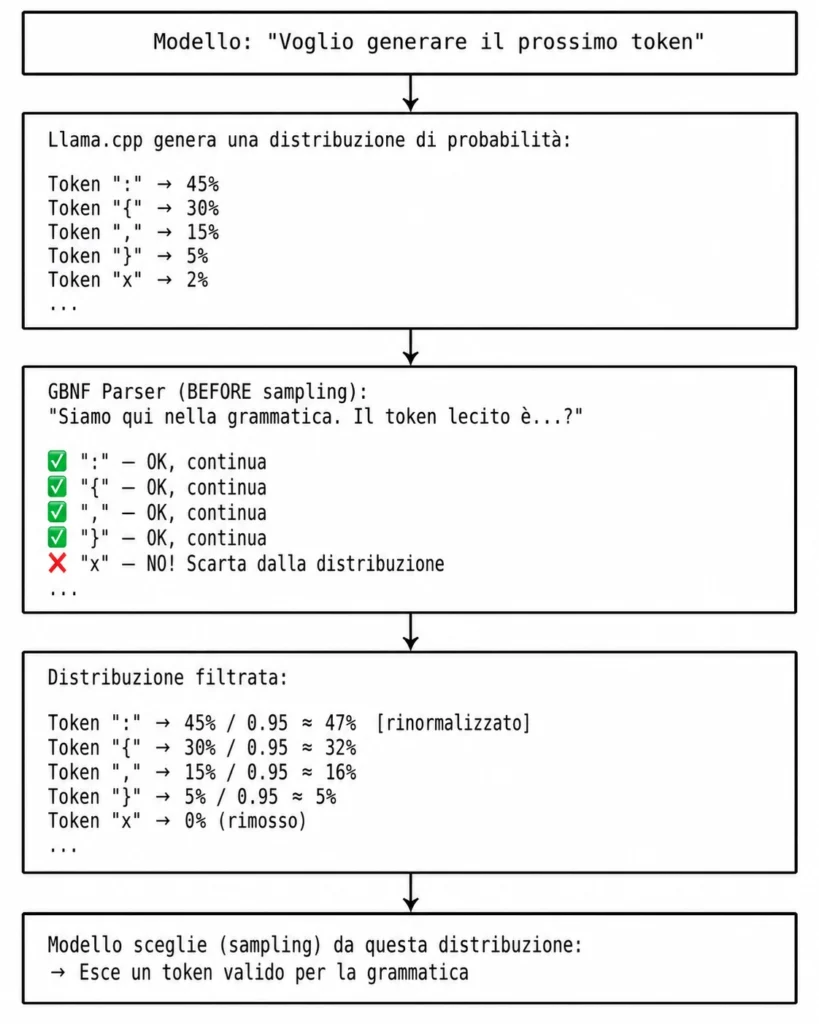
Con la GBNF, il motore llama.cpp fa una cosa diversa, a ogni singolo token che il modello sta per generare, calcola in anticipo quali token manterrebbero l’output ancora valido, e azzera la probabilità di tutti gli altri. Il modello non può scegliere una graffa fuori posto, letteralmente non gli viene data la possibilità. La nostra grammatica per un promemoria era così:
root   ::= "{" titolo data_o_intervallo "}"
titolo ::= "\"titolo\"" ":" "\"" [caratteri] "\""
data_o_intervallo ::= assoluta | relativa
assoluta ::= "\"data\"" ":" "\"AAAA-MM-GG\"" "," "\"ora\"" ":" "\"HH:MM\""
relativa ::= "\"fra\"" ":" [numero] "," "\"unita\"" ":" "\"minuti\"|\"ore\"|\"giorni\"|\"settimane\""Tradotto in italiano: il modello può scrivere un oggetto JSON con un titolo, e poi può scegliere tra due forme, una con data/ora precisa, una con “fra N minuti”. Non può generare una graffa in più, non può inventare un campo descrizione, non può mettersi a scrivere un preambolo. La grammatica lo vincola, token per token, a stare dentro queste righe.
Il vincolo token per token
Qui sta la magia e il motivo per cui la grammatica GBNF è diversa da un semplice controllo fatto dopo.
Immagina due scenari:
Scenario A (controllo DOPO): Il modello genera {"titolo": "Dentista", "data": "2026-02-31", "ora": "10:00"}. Il JSON è sintatticamente perfetto. Arriva a Python, json.loads() riesce, ma poi datetime.strptime() dice “il 31 febbraio non esiste”. Il promemoria viene rifiutato. L’utente vede un errore. Brutto.
Scenario B (vincolo DURANTE, con la grammatica): Il modello sta per generare “02-31” e non ha il permesso di farlo? No, il motore ha già calcolato che i soli “giorni” legali per febbraio sono 01-28 (o 29 in bisestili). Il modello sceglie 28 perché è l’unica opzione che gli rimane con probabilità non nulla.
Con la grammatica, il modello non può sbagliare sulla forma. Sulla semantica, invece il significato rimane possibile: può scegliere il 31 febbraio se glielo permetti, e lì scatta il secondo strato di difesa: Python.
Ma c’è un terzo strato e è il più interessante.
Non chiedergli l’aritmetica…
Alle 23:17, l’utente dice “ricordami fra 2 minuti”. Con la forma assoluta della grammatica, il modello doveva calcolare: “adesso sono le 23:17, fra 2 minuti sono le 23:19”. Suona semplice.
Ha fatto "ora": "00:19" — minuti giusti, ora sbagliata, data non avanzata.
Il modello ha sbagliato l’aritmetica dell’orologio. Non è un errore di forma (la grammatica l’avrebbe impedito). È un errore di senso e ha capito che servivano 19 minuti, ma non ha fatto il riporto di mezzanotte.
Qui arriva l’insegnamento vero: non puoi chiedere al modello di fare matematica nel contesto di generazione di testo strutturato. Non è quello che sa fare bene.
Soluzione? Una seconda forma della grammatica, la forma relativa:
relativa ::= "\"fra\"" ":" [numero] "," "\"unita\"" ":" "\"minuti\"|\"ore\"|\"giorni\"|\"settimane\""

Ora il modello non calcola niente. Legge "fra 2 minuti" e scrive:
{"titolo": "Accendere il condizionatore", "fra": 2, "unita": "minuti"}

Copia il numero, sceglie una parola. Le moltiplicazioni (2 minuti × 1 = 2 minuti, 3 ore × 60 = 180 minuti) e il riporto di mezzanotte le fa Python, che non sbaglia mai:
quando = (datetime.now() + timedelta(minutes=fra * UNITA_IN_MINUTI[unita])).replace(second=0, microsecond=0)Il principio: il modello serve dove c’è ambiguità linguistica da sciogliere (“domani” → quale giorno?). Dove il calcolo è puro, il codice è più sicuro.
Il parsing di Python
Ora il modello ha finito di generare. Lo stream si chiude. Arriva un JSON:
{"titolo": "Dentista", "fra": 2, "unita": "minuti"}Qui Python entra in azione. Non è un parser generico, è specifico per il significato che vogliamo dare a quel JSON.
json.loads(testo)— parsa il JSON grezzo. Grazie alla grammatica, questo quasi sempre riesce.valida_fra(titolo, fra, unita)— questo è il secondo strato di controllo, quello che la grammatica non può coprire:- Il titolo è una stringa non vuota?
fraè un numero positivo? (Non può essere -3, non può essere True che Python lo interpreta come 1)unitaè una delle quattro scelte permesse?- L’intervallo non è già passato?
- L’intervallo non è smisuratamente lontano (> 5 anni)?
- Creazione e salvataggio — se passa, il record viene scritto su
data/promemoria.json:
{
  "id": "20260810-231945",
  "titolo": "Dentista",
  "quando": "2026-08-10T23:19",
  "stato": "attesa",
  "evento_id": ""
}L’id lo assegna il server (non il modello — è il principio che ogni chiave viene dal server o da una fonte affidabile). Lo stato parte da “attesa”. L’evento_id è vuoto perché è stato scritto a mano (se venisse da Google Calendar avrebbe l’id dell’evento).
Il thread daemon che completa il quadro
Intanto, in background, un thread scritto in Python gira ogni 20 secondi:
def controlla(adesso):
    for gruppo in raggruppa_per_istante(scaduti(elenca(), adesso)):
        titolo, testo = testo_notifica(gruppo, adesso)
        notifica(titolo, testo)  # Windows Shell Notification
        for voce in gruppo:
segna_mostrato(voce["id"], adesso)Niente di magico, legge il file, confronta i timestamp, manda una notifica di Windows (via ctypes, senza dipendenze nuove). Se due promemoria scadono nello stesso minuto, una notifica sola li elenca entrambi. Se il file è corrotto, il thread sopravvive e riprova al giro dopo. Se il processo è spento, i promemoria “arretrati” compaiono come tali al riavvio.
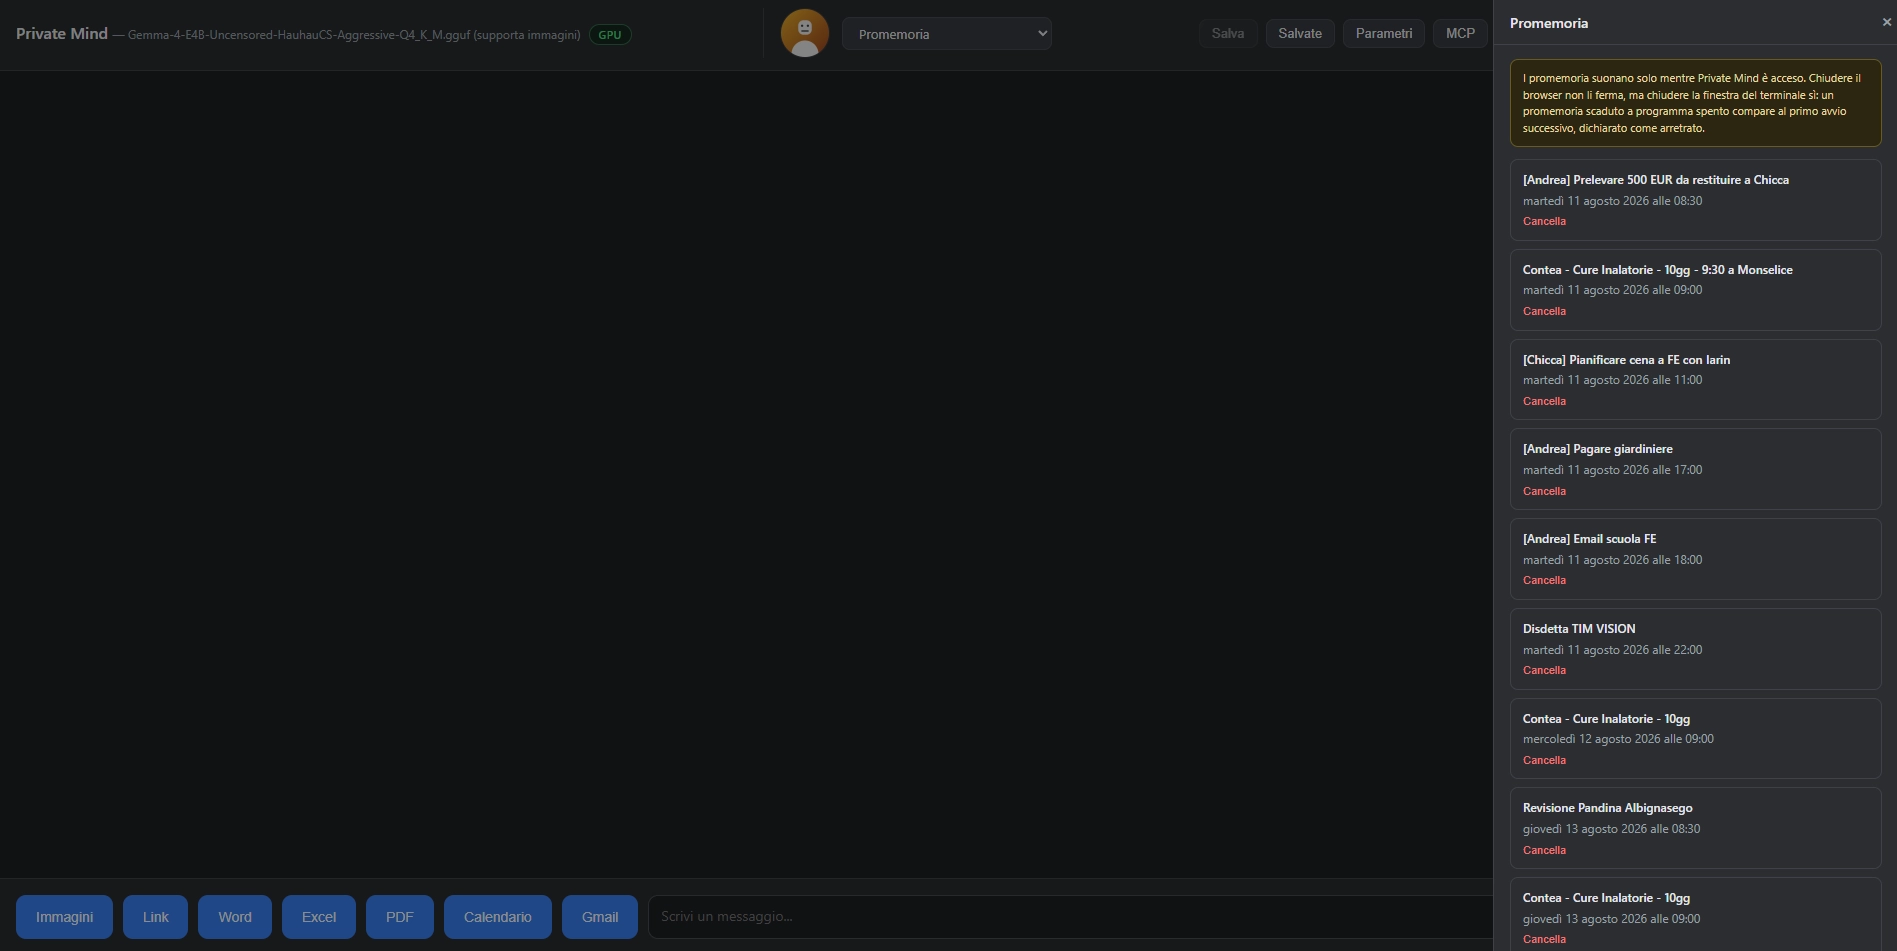
Questo breve viaggio dovrebbe farci riflettere sul fatto che non si tratta di stabilire se il modello sappia risolvere tutto oppure non sappia nulla, ma di affidargli i compiti per cui è realmente efficace e costruire intorno a esso i vincoli necessari. La conclusione apre poi uno sguardo sul futuro, suggerendo che questa architettura con vincoli durante la generazione e validazione a posteriori, diventerà probabilmente sempre più comune.
La vera intelligenza non è solo nel modello. È anche nel vincolo.
Se questo articolo ti è piaciuto, restiamo in contatto su linkedin a: https://www.linkedin.com/in/andreatonin/

| Editorial Manager at Pills for Nerds | CTO & Technology Consultant |
Technology professional, editor and lifelong nerd with over 30 years of experience in the digital and innovation sectors. I work as a CTO and technology consultant, designing complex and scalable software ecosystems, and I am also active in IT education and professional training. Alongside my technology career, I serve as Editorial Manager and contributor at Pills for Nerds, online publication covering video games, game development, emerging technologies, artificial intelligence, digital culture and industry events. In my editorial role, I coordinate content planning and contribute articles, interviews, event reports and in-depth features. You can learn more about my consulting work at lucedigitale.com and connect with me on LinkedIn

 By