Era una domanda da cinque minuti. Volevamo sapere se il modello locale che gira dentro Private Mind (una chat offline con Gemma in formato GGUF) esponesse una manopola per la temperatura, perché certe risposte sembravano più caute del necessario. Cinque minuti dopo la risposta era sì, e insieme alla risposta era arrivato un problema che nessuno aveva cercato.
La funzione che genera ogni risposta accetta ventisei parametri. Ne stavamo passando quattro. Gli altri ventidue non erano assenti: erano decisi da qualcun altro.
Questa distinzione è tutto l’articolo. Un parametro che non passi non sparisce, prende il valore che la libreria ha scelto per te, e quel valore non compare da nessuna parte nel tuo codice. Non c’è una riga da leggere, non c’è una costante da cercare, non c’è un commento che dica perché. C’è solo un comportamento, e quando quel comportamento ti sorprende non hai nessun appiglio per capirlo.
Impostazioni di default
Tre esempi, tutti veri, tutti scoperti quel pomeriggio.
Il primo: un filtro chiamato min_p era attivo al valore 0.05. Ritaglia la coda della distribuzione delle probabilità, il che significa che alzare la temperatura ha un effetto più contenuto di quanto ti aspetteresti. Nessuno l’aveva scelto. Nessuno sapeva che esistesse.
Il secondo, più insidioso: la penalità sulle ripetizioni era a 1.0, che nel gergo di llama.cpp non vuol dire “penalità bassa” ma “penalità disattivata”. La stessa libreria, in una funzione gemella usata per il completamento semplice, la imposta a 1.1. Noi eravamo capitati sulla variante che la spegne. Se una risposta lunga fosse entrata in loop (succede) la leva più diretta per curarla non era collegata a niente.
Il terzo riguarda il modello stesso. Google, per Gemma 3, raccomanda temperatura 1.0, top_k 64, top_p 0.95. Noi giravamo a 0.7 con top_k 40. Non è sbagliato in senso assoluto, è più conservativo di quanto il modello preveda per sé. Ed era il risultato di una riga scritta mesi prima, con un numero plausibile, mai più toccata.
Un problema da CTO e non da sviluppatore
Niente di tutto questo produce un errore. Nessun test rosso, nessun alert, nessuna eccezione in un log. Il sistema funziona esattamente come il giorno prima.
Il danno è un altro, ed è di attribuzione. Quando l’utente nota che le risposte sono più piatte del previsto, la colpa finisce sul modello. Si valuta di cambiare quantizzazione, si guarda un modello più grande, si mette a bilancio della GPU. In un’azienda quella catena di ragionamenti arriva a costare davvero, e parte tutta da una domanda che nessuno ha pensato di fare: siamo sicuri di sapere con che impostazioni stiamo girando?
La generalizzazione è immediata e non riguarda solo gli LLM. Ogni dipendenza che integrate ha dei default. Il vostro client HTTP ha un timeout che qualcuno ha scelto, il vostro pool di connessioni ha una dimensione massima, il vostro ORM ha un livello di isolamento delle transazioni. Nessuno di questi è documentato nel vostro repository, perché tecnicamente non è codice vostro. Ma è comportamento vostro, e quando un cliente vi chiede perché il sistema si comporta in un certo modo, “è il default della libreria” non è una risposta che potete dare due volte.
La domanda utile non è “il nostro sistema è configurabile”. Quasi sempre lo è. La domanda è: sappiamo dire, senza aprire il codice sorgente di una dipendenza, com’è configurato adesso?
La disciplina che è costata più della funzionalità
Qui arriva la parte che vale la pena raccontare a chi decide, perché è controintuitiva.
Avendo scoperto che la penalità sulle ripetizioni era disattivata, e avendo davanti la raccomandazione ufficiale di Google, la cosa ovvia era sistemare tutto mentre eravamo lì. Abbiamo deciso di non farlo.
I valori scritti nel codice sono la copia esatta di quelli che subivamo prima. Identici, deliberatamente. Rendere esplicito un default non doveva cambiare il comportamento di un singolo token, e c’è un test automatico il cui unico scopo è verificare che non sia cambiato.
Il motivo è che due modifiche impacchettate insieme sono indistinguibili. Se avessimo alzato la penalità nella stessa sessione intitolata “rendere leggibili le impostazioni”, e nelle settimane successive qualcuno avesse notato risposte diverse, non avrebbe avuto nessun modo di collegare le due cose. Avremmo trasformato un problema di visibilità in un problema di visibilità più una regressione difficile da tracciare.
I valori diversi (compresi quelli consigliati da Google) sono finiti altrove: in tre preset selezionabili, dove sono una scelta che si vede e si può disfare.
Il taglio conta quanto l’aggiunta
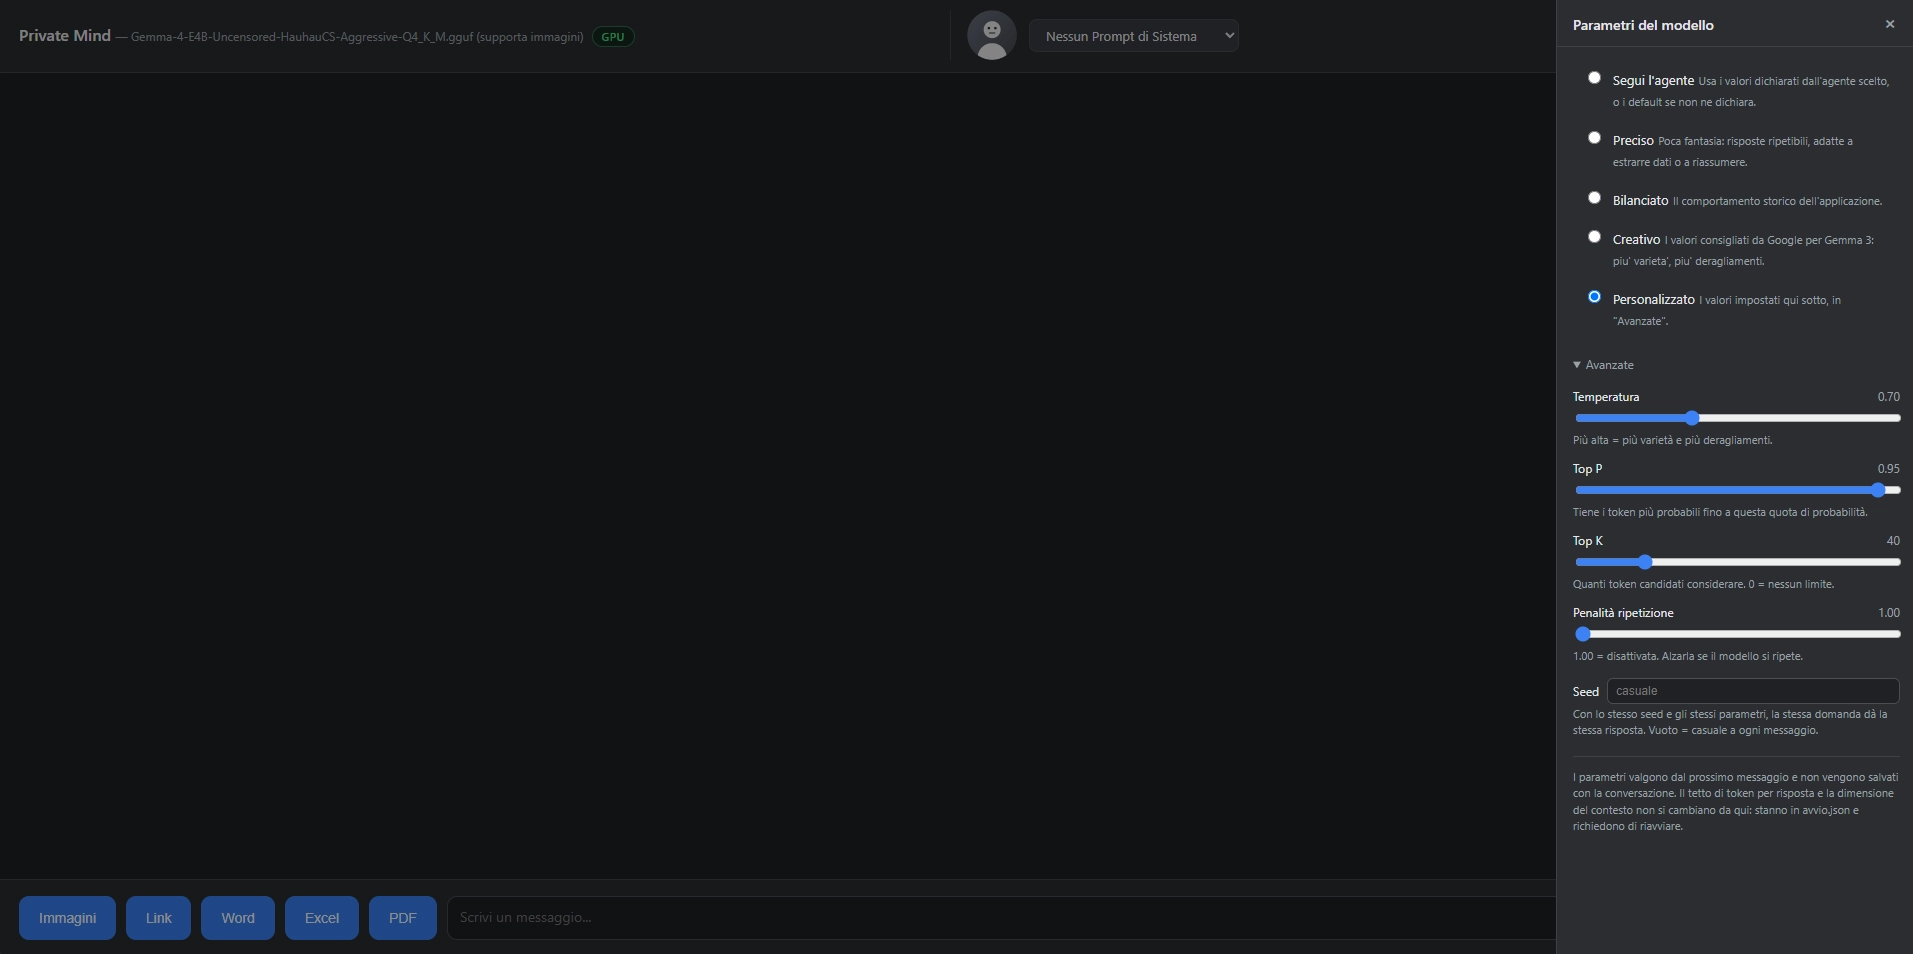
Esposti nell’interfaccia: temperatura, top_p, top_k, penalità ripetizione, seed. Cinque leve su ventisei.
L’esclusione più interessante è una famiglia di parametri chiamata mirostat. Fa una cosa legittima e utile, ma quando è attiva scavalca top_k e top_p. Un pannello che li mostrasse tutti insieme si contraddirebbe da solo: l’utente sposterebbe due cursori che non hanno più alcun effetto, senza nessun segnale che glielo dica. Abbiamo preferito una scatola degli attrezzi più piccola e onesta a una completa e bugiarda.
Stesso ragionamento sulla forma. Non cinque cursori nudi, ma quattro scelte con nome (Segui l’agente, Preciso, Bilanciato, Creativo) e i cursori nascosti dietro un pannello avanzato. Cinque numeri crudi in un’interfaccia producono configurazioni rotte che poi sembrano, di nuovo, colpa del modello.
Quello che resta
Il lavoro è durato un pomeriggio e ha prodotto tre moduli, un pannello e cinquantacinque test in più. Ma se dovessi indicare la cosa che ha cambiato davvero il progetto, non è nessuna di queste. È che adesso esiste un posto dove andare a leggere con che impostazioni gira il modello, e quel posto risponde senza che si debba aprire il sorgente di una dipendenza.
Se l’articolo ti è piaciuto restiamo in contatto su linkedin a: https://www.linkedin.com/in/andreatonin/
#defaultimpliciti #debitotecnico #configurabilità #llmlocali #osservabilità #decisionidiprodotto #errorediattribuzione #designdellescelte #configurazioneesterna #manutenibilità

| Editorial Manager at Pills for Nerds | CTO & Technology Consultant |
Technology professional, editor and lifelong nerd with over 30 years of experience in the digital and innovation sectors. I work as a CTO and technology consultant, designing complex and scalable software ecosystems, and I am also active in IT education and professional training. Alongside my technology career, I serve as Editorial Manager and contributor at Pills for Nerds, online publication covering video games, game development, emerging technologies, artificial intelligence, digital culture and industry events. In my editorial role, I coordinate content planning and contribute articles, interviews, event reports and in-depth features. You can learn more about my consulting work at lucedigitale.com and connect with me on LinkedIn

 By