
Nel frenetico mondo dell’Intelligenza Artificiale, un nuovo termine sta dominando le discussioni tecniche: “Loop Engineering”. C’è chi sussurra che il “prompt engineering sia ormai morto” e chi, invece, vede questa nuova fase come una naturale e necessaria evoluzione. Ma di cosa parliamo esattamente? Si tratta dell’ennesima trovata di marketing o siamo davvero di fronte a un cambio di paradigma che ridefinirà il nostro modo di interagire con le macchine? Per comprenderlo, dobbiamo compiere un viaggio attraverso le ere che hanno caratterizzato lo sviluppo dell’IA generativa, esplorando come siamo passati dalla semplice digitazione di comandi alla gestione di veri e propri ecosistemi autonomi.
Dal Prompt al Context Engineering
Tutto è iniziato con il Prompt Engineering. In questa fase primordiale, il nostro compito era essenzialmente quello di scrivere istruzioni dettagliate (il cosiddetto system prompt) per guidare il modello. Chiedevamo all’IA di agire in un certo modo, inserendo regole, limitazioni ed esempi di risposte corrette. Sebbene efficace per compiti lineari, questo approccio mostrava rapidamente i suoi limiti di aggiornamento e persistenza.
È qui che entra in gioco il Context Engineering. I modelli hanno iniziato a utilizzare strumenti esterni, navigando sul web, leggendo file locali e interfacciandosi con le applicazioni tramite protocolli come l’MCP (Model Context Protocol). L’IA riempiva autonomamente la sua “finestra di contesto” (la sua memoria a breve termine) con dati pertinenti prima di rispondere. Tuttavia, all’aumentare dei token, le prestazioni del modello degradano drasticamente e la macchina inizia a “confondersi”. Ciò ha costretto i sistemi a continue operazioni di riassunto (“compaction”) per liberare spazio, rendendo questa tecnica inefficace per task che richiedono più di 5-10 minuti.
L’impalcatura: L’Harness Engineering
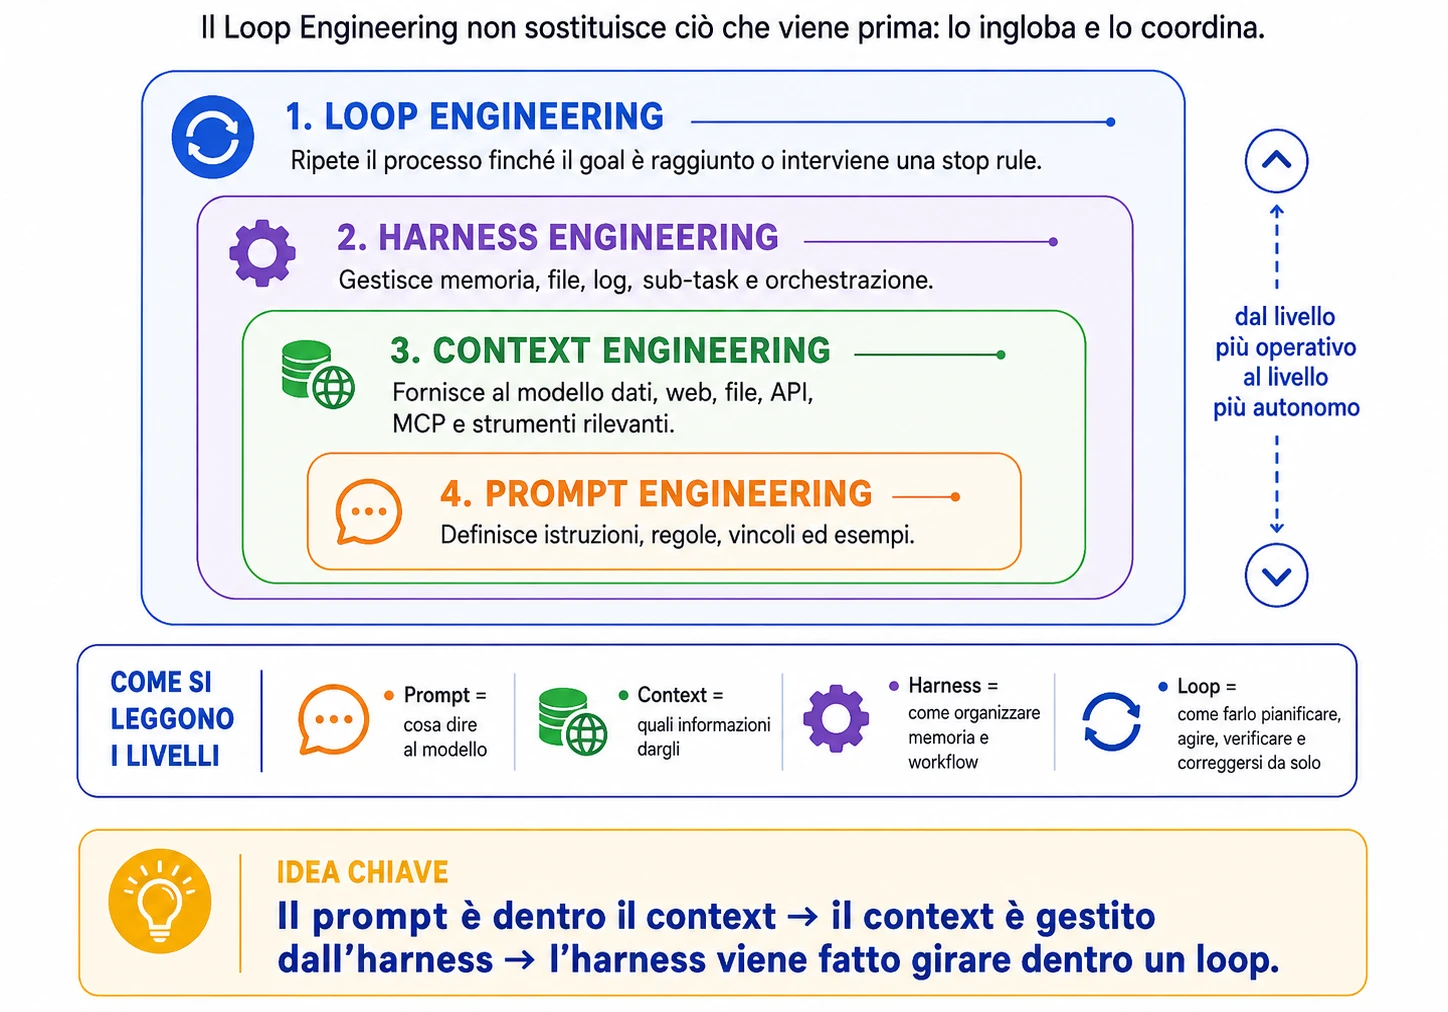
Per superare i colli di bottiglia della memoria, l’ingegneria dell’IA ha fatto un passo fuori dal modello, dando vita all’Harness Engineering. Immaginate l’Harness come un’impalcatura esterna che struttura e gestisce il contesto. Invece di intasare la Context Window, i task lunghi e complessi vengono suddivisi in sotto-task, e l’agente “scrive” fisicamente i suoi progressi e le sue memorie su file locali, come i Markdown (es. memory.md o file di log giornalieri). Svuotando completamente il suo contesto e ricaricando solo ciò che gli serve dal file system a ogni step, l’agente lavora senza interruzioni e con una memoria a lungo termine. È il sistema ideale per gestire richieste enormi, come clonare l’architettura di un intero sito o analizzare decine di competitor su più database.
L’autonomia: Il Loop Engineering
Se l’Harness Engineering fornisce la struttura, il Loop Engineering fornisce il motore perpetuo. Si tratta di avvolgere l’intera impalcatura (l’Harness e il Context) all’interno di un ciclo continuo e autogestito. Nel Loop Engineering, l’utente perde (volutamente) il controllo granulare. È l’agente stesso che progetta il loop, si fa le domande, pianifica, agisce, analizza e si corregge in autonomia. Questo processo ciclico suddivide e delega il lavoro a molteplici “sub-agenti” specializzati che operano in parallelo (es. uno ricerca dati finanziari, uno esamina il codice sorgente, un altro verifica le metriche). Un loop può avviarsi automaticamente tramite specifici inneschi (trigger) temporali o di evento, come l’apertura di un’issue su GitHub o la pubblicazione di nuove notizie online. Questo permette, per esempio, a un’applicazione di auto-aggiornarsi, risolvere i propri bug e compilare nuovo codice senza che alcun essere umano intervenga a correggere il prompt.
Come funziona nel concreto?
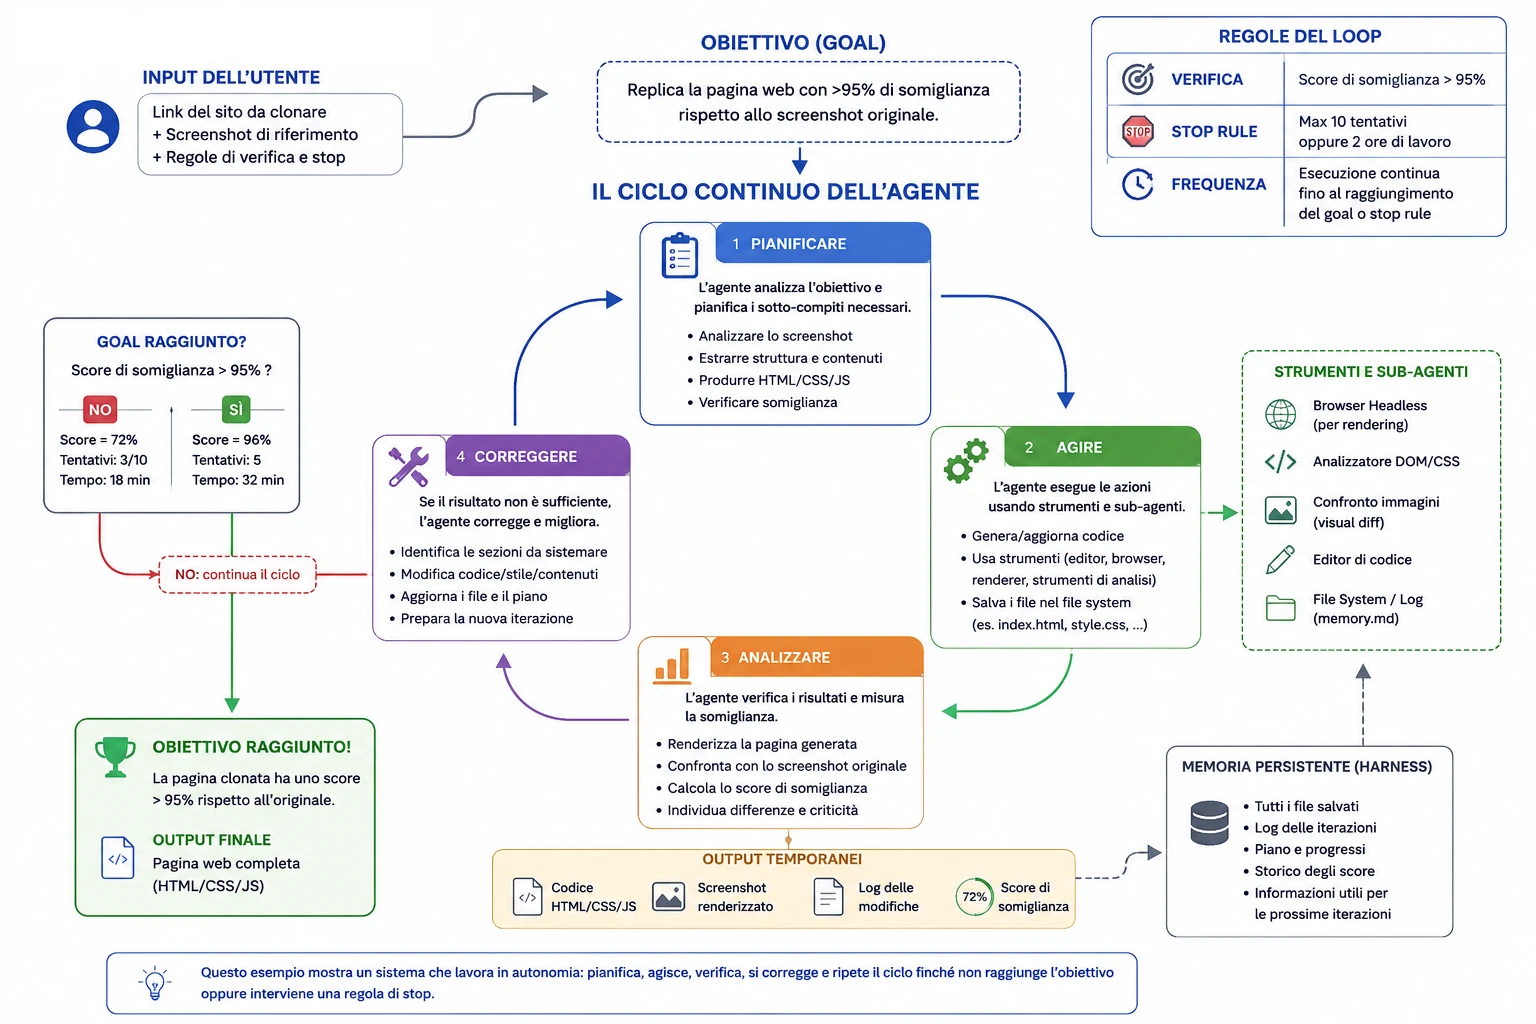
Nel concreto, il Loop Engineering si basa su una struttura a più livelli che impila cicli diversi (dall’uso di strumenti singoli alla gestione di compiti complessi). Il funzionamento di un loop si sviluppa principalmente attraverso quattro fasi chiave gestite dall’agente:
- Pianificazione: L’agente riceve un obiettivo generale e definisce autonomamente i sotto-compiti necessari per raggiungerlo.
- Azione: L’agente avvia sub-agenti o utilizza strumenti esterni (database, API, ricerche web, protocolli MCP) per raccogliere dati o modificare file.
- Analisi: Durante il processo, l’agente monitora l’avanzamento, verifica se mancano informazioni o se ci sono errori.
- Correzione: Se qualcosa non va, l’agente corregge il tiro e ricomincia il ciclo finché il compito non è completato con successo.
Per far funzionare un loop senza che vada fuori controllo o consumi troppi token in cicli infiniti, è indispensabile configurare tre pilastri fondamentali:
- Obiettivi chiari (Goal): Un traguardo finale ben definito e misurabile.
- Regole di verifica: I criteri per stabilire se il lavoro è stato fatto bene.
- Regole di stop (o terminazione): Un limite massimo (es. “fai al massimo 10 tentativi” o “fermati dopo 8 ore”) per evitare cicli infiniti su compiti impossibili
I 5 livelli di verifica dell’output
Per capire quando fermare il ciclo, il sistema può utilizzare diversi tipi di verifica dell’obiettivo:
- Deterministica: Una risposta booleana (vero/falso), ad esempio se il codice compila senza errori.
- Regole e vincoli numerici: Limiti precisi, come un tempo di caricamento di una pagina web inferiore a 100 millisecondi o un’accuratezza superiore al 90%.
- Verità terrena ritardata (Delayed Ground Truth): Obiettivi i cui risultati arrivano con un ritardo temporale (es. ottimizzare un post social monitorando se raggiunge 300 reazioni nei giorni successivi).
- L’LLM come giudice: Il modello valuta se stesso. Ad esempio, confronta il rendering visivo di una pagina web clonata con uno screenshot originale e si assegna un punteggio di somiglianza da 1 a 100 finché non è soddisfatto.
- Checkpoint umano: L’utente interviene direttamente per valutare ogni modifica e dare un feedback o un punteggio per guidare il ciclo successivo
Esempi pratici
- Ottimizzazione di codice ed algoritmi: Un utente fornisce uno script per il calcolo di matrici e imposta un loop per migliorarne le prestazioni. Il sistema esegue autonomamente svariati tentativi di ottimizzazione (passando a NumPy, PyTorch, CUDA, ecc.), scrive un registro delle modifiche in markdown e si ferma dopo aver ottenuto, ad esempio, un incremento di velocità di oltre 300 volte.
- Risoluzione automatica di bug (Self-Healing Apps): Un loop collegato a GitHub si attiva ogni volta che un utente segnala un problema (issue). L’agente analizza l’errore, riscrive il codice, avvia i test di verifica e applica la correzione in totale autonomia.
- Analisi di mercato e dei competitor: Chiedendo un’analisi dettagliata di 10 competitor, l’agente attiva diversi sub-agenti in parallelo: uno analizza i social media, un altro estrae dati di investimento e venture capital dai database, e un terzo esamina i bilanci pubblici. Una volta raccolte e verificate tutte le informazioni, i dati vengono uniti in un report finale in PDF.
- Clonare una pagina web: vedi flowchart sotto
Quando usarlo e quando evitarlo?
- Sì, se: Il compito è ripetibile, il risultato è verificabile, e il sistema ha accesso a strumenti esterni (database, API, file system locale) per agire e ricevere feedback.
- No, se: I compiti sono estremamente semplici o estemporanei (es. tradurre una mail al volo o chiedere 5 idee per un gioco) o se l’obiettivo è troppo vago e non permette di stabilire una chiara regola di stop.
Recap in breve
Per maggiore chiarezza, riassumo i concetti principali nella tabella seguente.
| Fase | Idea centrale | Ruolo dell’uomo | Ruolo dell’IA | Limite principale |
|---|---|---|---|---|
| Prompt Engineering | Scrivere istruzioni efficaci | Scrive prompt e regole | Esegue | Poco adatto a task complessi e persistenti |
| Context Engineering | Fornire il contesto giusto | Collega dati e strumenti | Cerca, legge file, usa web/API/MCP | La context window si riempie |
| Harness Engineering | Costruire un’impalcatura esterna | Progetta workflow, memoria e strumenti | Salva stato, divide task, riprende il lavoro | Serve ancora un sistema che orchestri il processo |
| Loop Engineering | Rendere il workflow ciclico e autonomo | Definisce obiettivi, vincoli e verifiche | Pianifica, agisce, controlla e corregge | Rischio di loop infiniti, costi ed errori autonomi |
Il Loop Engineering non cancella le discipline precedenti, ma le ingloba. Segna la fine dell’epoca del semplice “copilota“, tramutandoci a tutti gli effetti in “manager di agenti“. Il nostro ruolo si eleva, non dobbiamo più scrivere prompt chilometrici, ma definire architetture strategiche e flussi decisionali entro i quali l’IA può, infine, prosperare in autonomia.
Se l’articolo ti è piaciuto restiamo in contatto su linkedin a https://www.linkedin.com/in/andreatonin/

| Editorial Manager at Pills for Nerds | CTO & Technology Consultant |
Technology professional, editor and lifelong nerd with over 30 years of experience in the digital and innovation sectors. I work as a CTO and technology consultant, designing complex and scalable software ecosystems, and I am also active in IT education and professional training. Alongside my technology career, I serve as Editorial Manager and contributor at Pills for Nerds, online publication covering video games, game development, emerging technologies, artificial intelligence, digital culture and industry events. In my editorial role, I coordinate content planning and contribute articles, interviews, event reports and in-depth features. You can learn more about my consulting work at lucedigitale.com and connect with me on LinkedIn

 By