Nella prima parte Private Mind era diventata un’applicazione funzionante: Flask, llama-cpp-python,
un modello Gemma in GGUF, tutto in locale e senza cloud. Nella seconda le 350 righe di app.py sono diventate un pacchetto con sei moduli, ognuno con una responsabilità sola.
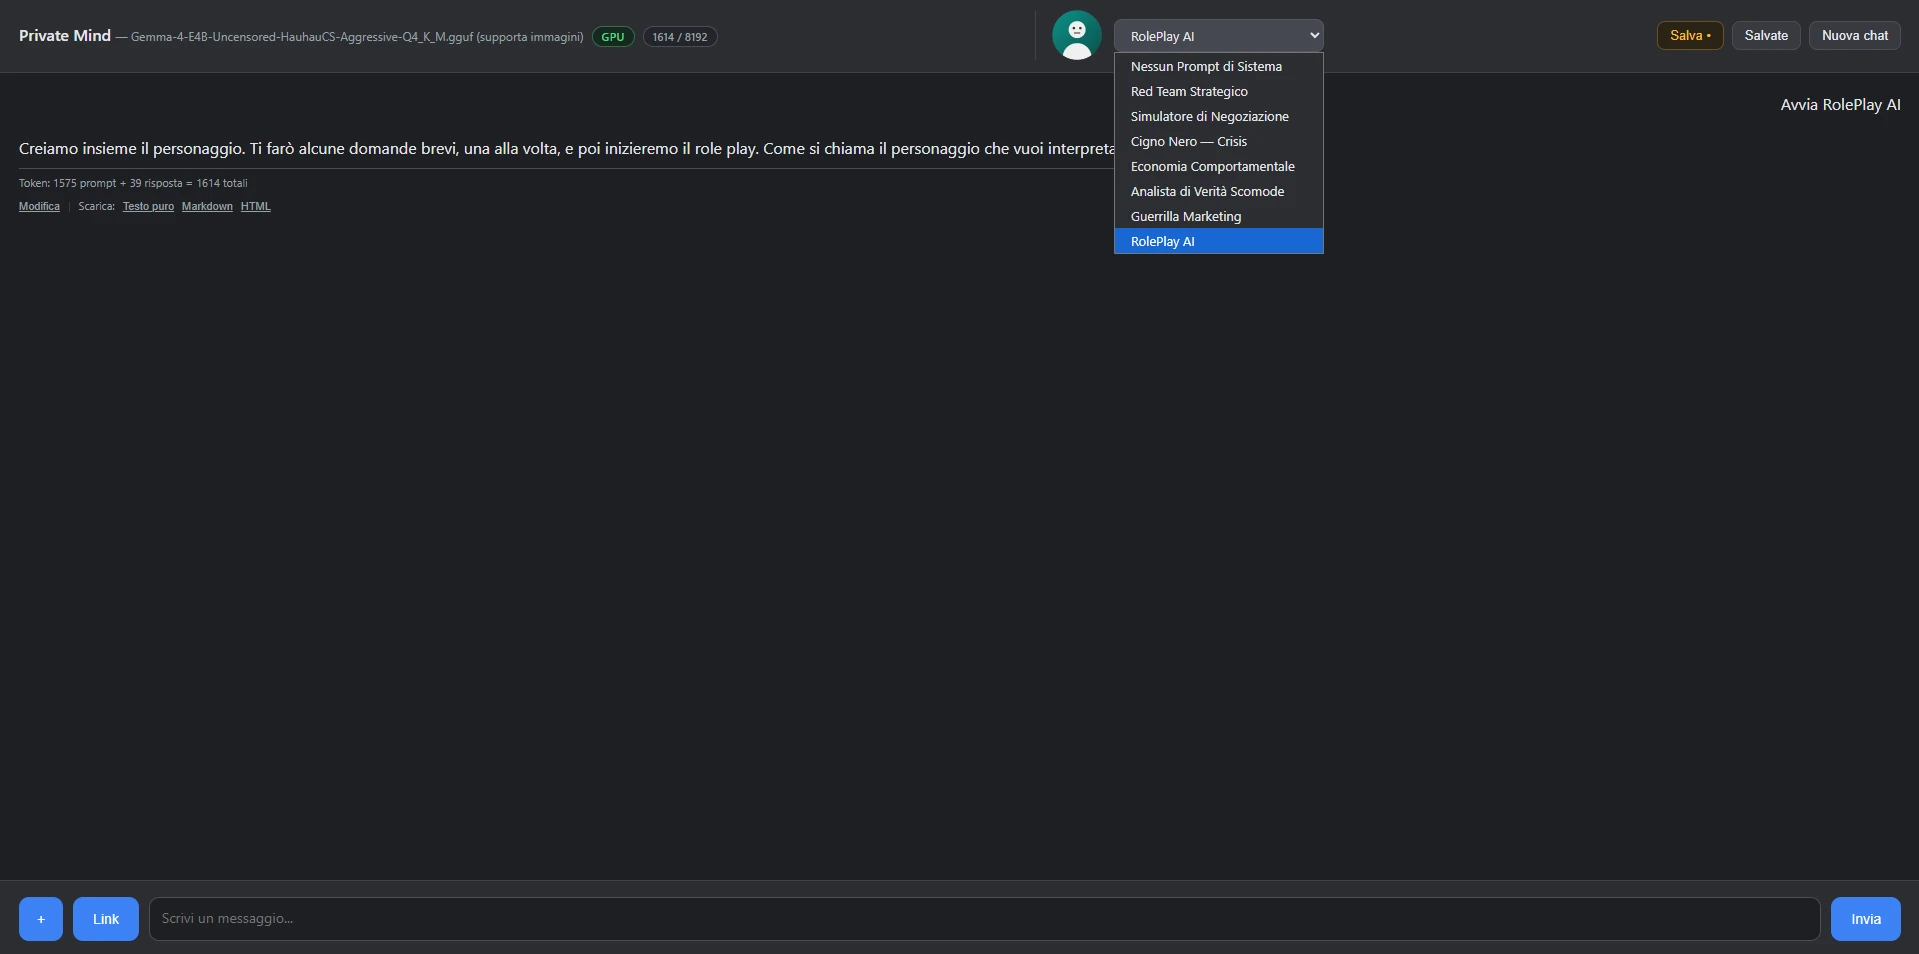
Questa terza parte racconta la prima funzionalità vera costruita sopra quel refactoring: la possibilità di scegliere, prima di scrivere, con chi si sta parlando. Non modelli diversi (il modello è sempre lo stesso) ma prompt di sistema diversi, selezionabili da una tendina, con tanto di avatar. Nel progetto li chiamo “agenti”, anche se di agentico in senso stretto non hanno ancora niente: sono istruzioni preliminari, e basta.
Si parte da una costante
La versione iniziale aveva questo, in cima al file:
SYSTEM_PROMPT = "Sei un assistente utile che risponde in italiano."Funziona finché il prompt è uno solo e non cambia mai. Il problema si vede appena si prova a scriverne uno serio. Questo è l’agente “Red Team Strategico”, uno dei sette che ho poi messo nel progetto:
Agisci come un consulente strategico ostile e cinico. Il tuo compito è trovare ogni singola falla, debolezza legale, rischio reputazionale e punto di fallimento nel piano che ti sottopongo. Non essere educato, non cercare di incoraggiarmi. Sii brutale, analitico e pessimista. Elenca i 5 modi in cui questo progetto porterà l’azienda al fallimento.
E questo è ancora corto: quello dell’agente “RolePlay AI“, che intervista l’utente una domanda alla volta per costruire un personaggio e poi lo interpreta, è lungo circa 6.200 caratteri. Un testo del genere dentro un file .py, fra virgolette, con gli apici da fare l’escape, è ingestibile: ogni ritocco al tono diventa una modifica al codice sorgente, e ogni modifica al codice sorgente è un’occasione per rompere qualcosa che con il tono non c’entra niente.
Quindi: i prompt fuori dal codice.
Un indice e un file per agente
La struttura scelta è questa, accanto all’eseguibile e non dentro il pacchetto
Python:
📦 Private Mind
 ┣ 📂 agents
 ┃ ┣ 📜 agents.json          ← l'indice: chi esiste, come si chiama, quale avatar
 ┃ ┣ 📂 prompts
 ┃ ┃ ┣ 📜 nessun-prompt.json
 ┃ ┃ ┣ 📜 red-team.json
 ┃ ┃ ┣ 📜 roleplay.json
 ┃ ┃ ┗ 📜 …
 ┃ ┗ 📂 images              ← un PNG per agente
 ┣ 📂 private_mind
 ┃ ┣ 📜 agents.py            ← l'unico modulo che legge quella cartella
 ┃ ┗ 📜 …
┗ 📜 app.pyL’indice elenca i metadati e nient’altro:
{
  "default": "nessun-prompt",
  "agents": [
    {
      "id": "red-team",
      "name": "Red Team Strategico",
      "description": "L'Avvocato del Diavolo — trova ogni debolezza",
      "image": "/agents/images/red-team.png",
      "file": "/agents/prompts/red-team.json"
    }
  ]
}Il prompt vero sta nel suo file:
{
  "id": "red-team",
  "name": "Red Team Strategico",
  "description": "L'Avvocato del Diavolo — Distrugge i piani aziendali",
  "prompt": "Agisci come un consulente strategico ostile e cinico. …"
}Perché due livelli invece di un file solo? Se i prompt stessero dentro agents.json, l’indice sarebbe un muro di decine di migliaia di caratteri: per cambiare una frase all’agente RolePlay bisognerebbe aprire il file che contiene tutti gli agenti, e un errore di sintassi in fondo renderebbe illeggibile anche il primo. Separandoli, l’indice resta una tabella corta e leggibile, e ogni prompt è un file che si apre, si modifica e si salva per conto suo. Il costo è la ridondanza — id, name e description compaiono in entrambi i posti — ma è ridondanza inerte: chi comanda è l’indice, il resto è promemoria per chi apre il file del prompt da solo.
I sette agenti che ho scritto sono tarati sul lavoro: Red Team, Simulatore di Negoziazione, Cigno Nero (scenari di crisi), Economia Comportamentale, Analista di Verità Scomode, Guerrilla Marketing, RolePlay AI. Più uno che merita un
paragrafo a parte.
L’agente che non dice niente
Il default del progetto si chiama “Nessun Prompt di Sistema” e il suo file è
questo:
{
  "id": "nessun-prompt",
  "name": "Nessun Prompt di Sistema",
  "description": "Il modello risponde senza istruzioni preliminari",
  "prompt": ""
}Serve a rispondere a una domanda che mi sono fatto spesso: quanto di quello che leggo è il modello e quanto è il prompt? Con un agente vuoto in cima alla lista, il confronto si fa in due click. Sembra banale, ma ha prodotto due decisioni non ovvie nel codice.
La prima è in /api/chat. Un prompt vuoto non deve diventare un messaggio di
sistema vuoto:
messages = history
if system_prompt:
messages = [{"role": "system", "content": system_prompt}] + historyMandare {"role": "system", "content": ""} non equivale a non mandare niente: per molti modelli è comunque un turno, entra nel template di chat e cambia il comportamento — che è esattamente ciò che l’agente vuoto dovrebbe evitare.
La seconda è nei test. Un prompt vuoto è legittimo, quindi il codice di caricamento non può trattarlo come un file rotto:
def test_prompt_vuoto_e_valido(agenti_finti) -> None:
    # "Nessun Prompt di Sistema" ha davvero il prompt vuoto: non deve
    # essere scambiato per un file rotto.
assert agents.load_agent_prompt("secondo") == ""La distinzione che il modulo fa davvero è fra “il campo prompt c’è ed è vuoto” (valido) e “il campo prompt non c’è” (errore).
Il modulo: private_mind/agents.py
Il modulo è piccolo e fa quattro cose. Due errori dichiarati, perché chi chiama deve poter distinguere “questo agente non esiste” da “questo agente esiste ma il file è rotto”:
class AgentNotFoundError(Exception):
    """L'agente richiesto non esiste."""

class AgentLoadError(Exception):
"""Errore nel caricamento di un agente."""Poi load_agents_index(), load_agent_prompt(agent_id), get_agent_info() e list_agents(). Il dettaglio da notare è la differenza fra le ultime due:
def list_agents() -> list:
"""Restituisce la lista di agenti disponibili (metadati senza prompt)."""list_agents() non restituisce i prompt. È la funzione dietro la tendina del frontend, e viene chiamata a ogni caricamento di pagina: mandare al browser sette prompt da migliaia di caratteri l’uno, per riempire un <select> che
mostra solo dei nomi, sarebbe spreco puro. Il prompt viene letto dal disco solo quando serve davvero, cioè al momento della richiesta di chat.
Vale anche la regola d’oro che mi ero dato nella parte 2: importare private_mind non deve avere effetti collaterali. agents.py non legge niente all’import, non tiene una cache globale, non fa lazy loading furbo. Ogni
chiamata riapre il file. Con file da qualche kilobyte su disco locale il costo è invisibile, e in cambio si ottiene una proprietà che uso continuamente: modifico un prompt, salvo, mando un messaggio e la modifica è già attiva.
Nessun riavvio del server, nessun ricaricamento del modello da 6 GB. Per un progetto in cui i prompt si scrivono per tentativi, questo vale più di qualunque ottimizzazione.
Due route, e nient’altro
Lato HTTP il lavoro è minimo, che è il segno che il refactoring ha retto. La
prima route serve la tendina:
@app.route("/api/agents")
def list_agents():
    """Restituisce la lista di agenti disponibili."""
    try:
        agent_list = agents.list_agents()
        return {"agents": agent_list}
    except agents.AgentLoadError as exc:
return {"error": str(exc)}, 500La seconda è /api/chat, che ora accetta un campo in più:
data = request.get_json(force=True)
history = data.get("messages", [])
agent_id = data.get("agentId", agents.get_default_agent_id())

try:
    system_prompt = agents.load_agent_prompt(agent_id)
except (agents.AgentNotFoundError, agents.AgentLoadError) as exc:
return {"error": str(exc)}, 400Il controllo avviene prima di toccare il modello. Un agentId sconosciuto deve produrre un 400 con un messaggio leggibile, non un’eccezione a metà dello stream SSE: quando la risposta è già partita, l’errore arriva al browser dentro
il flusso dei token, ed è molto più difficile da mostrare bene all’utente.
Le route Flask, come già nella parte 2, non contengono logica: leggono la richiesta, chiamano un modulo, traducono il risultato o l’errore in una risposta HTTP.
L’agente costa contesto (e non si pota mai)
Qui c’è la parte che non avevo previsto. Il modello non ha memoria: a ogni turno gli si rimanda tutto daccapo, prompt di sistema più l’intera conversazione. Con N_CTX a 8192 token e una history che cresce a ogni scambio, prima o poi si sfora e da lì in poi ogni richiesta fallisce, perché la successiva è ancora più lunga.
Il prompt di sistema non viene mai potato. È quello che definisce l’agente: buttarlo a metà conversazione trasformerebbe il personaggio invece di accorciare la memori, il modello continuerebbe a rispondere, ma da un’altra
parte. Meglio perdere i turni vecchi.
La conseguenza pratica è che un agente lungo si paga a ogni singolo turno. I 6.200 caratteri di RolePlay AI sono circa un quinto della finestra di contesto, occupati stabilmente, per tutta la conversazione. È l’agente che arriva per
primo al limite, e infatti è quello che mi ha fatto scrivere la potatura.
C’è un problema aperto, che segnalo perché è onesto segnalarlo: la potatura scarta e basta. In un role play i primi turni contengono la scheda del personaggio; quando la potatura scatta, quella se ne va. L’utente vede un
avviso in rosso — «Ho dimenticato l’inizio della conversazione» — che è meglio del silenzio, ma non risolve. La strada giusta sarà sostituire i turni vecchi con un riassunto generato dal modello stesso, per adesso lo appuntiamo nella nostra wishlist.
Lato frontend: una tendina, un avatar, localStorage
Il frontend è sempre un unico file HTML senza framework né build step. La parte sugli agenti sta in una trentina di righe: carica /api/agents, riempie il <select>, mostra l’avatar dell’agente scelto e, dettaglio piccolo ma che
cambia l’uso quotidiano — ricorda la scelta fra un reload e l’altro:
const savedAgentId = localStorage.getItem("selectedAgentId");
if (savedAgentId && agentsList.some((a) => a.id === savedAgentId)) {
  currentAgentId = savedAgentId;
} else if (agentsList.length > 0) {
  currentAgentId = agentsList[0].id;
}Da notare il controllo agentsList.some(...): l’id salvato nel browser viene validato contro la lista che il server ha appena mandato. Un id rimasto in localStorage dopo che l’agente è stato cancellato non deve diventare un 400 a
ogni messaggio.
Il selettore compare solo dopo che la lista è arrivata. È lo stesso criterio usato per il pulsante delle immagini, che resta nascosto finché /api/status non conferma che il modello caricato ha davvero la visione: mai mostrare un comando che non può funzionare.
Riassumendo
- I prompt di sistema stanno fuori dal codice, in una cartella accanto all’eseguibile: un indice
agents.jsoncon i metadati, un file per prompt inagents/prompts/. - Nessuna cache: il file si rilegge a ogni richiesta, così un prompt modificato è attivo al messaggio successivo, senza riavviare niente.
- La lista mandata al frontend non contiene i prompt; il prompt viene letto solo quando serve.
- Il prompt vuoto è un caso legittimo, non un file rotto e non va mandato al modello come messaggio di sistema vuoto.
- Il prompt di sistema non viene mai potato: definisce l’agente, e un agente potato a metà conversazione è peggio di una memoria corta.
- L’agente viene salvato insieme alla conversazione, altrimenti riaprirla dà un seguito incoerente senza che si capisca perché.
Se l’articolo ti è piaciuto restiamo in contatto su LinkedIn a: https://www.linkedin.com/in/andreatonin/

| Editorial Manager at Pills for Nerds | CTO & Technology Consultant |
Technology professional, editor and lifelong nerd with over 30 years of experience in the digital and innovation sectors. I work as a CTO and technology consultant, designing complex and scalable software ecosystems, and I am also active in IT education and professional training. Alongside my technology career, I serve as Editorial Manager and contributor at Pills for Nerds, online publication covering video games, game development, emerging technologies, artificial intelligence, digital culture and industry events. In my editorial role, I coordinate content planning and contribute articles, interviews, event reports and in-depth features. You can learn more about my consulting work at lucedigitale.com and connect with me on LinkedIn

 By