Private Mind è un’applicazione che esiste per una ragione precisa: far girare un modello linguistico sul computer di chi lo usa, senza che un solo byte di quella conversazione lasci la macchina. È la sua identità, non una funzione fra le tante. Quando il team ha deciso di aggiungere un pulsante che legge la posta di Gmail, quella identità è entrata in tensione con se stessa, ogni connessione verso l’esterno è, per un prodotto così, un’eccezione da giustificare, non un’integrazione da spuntare in una lista.
La prima decisione
La prima decisione, quella che ha condizionato tutte le altre, riguarda cosa non installare. Google mette a disposizione librerie ufficiali per parlare con le sue API (google-api-python-client, google-auth-oauthlib), pensate per risparmiare tempo agli sviluppatori. Il team le ha scartate, e non per pregiudizio verso il codice altrui, le ha misurate. Installare quelle librerie avrebbe portato con sé una dozzina di pacchetti aggiuntivi, alcuni compilati, per un’applicazione che punta a essere distribuita come un singolo eseguibile scaricabile e cliccabile. Ogni dipendenza compilata è una superficie di build da mantenere su più sistemi operativi, un punto in più dove qualcosa può rompersi in fase di packaging senza un messaggio d’errore chiaro. Il calcolo è stato semplice: scrivere a mano un client OAuth2 (poche centinaia di righe, usando solo librerie già presenti in Python) costa più tempo di sviluppo oggi, ma costa meno manutenzione per sempre. È la stessa logica che aveva già escluso, mesi prima, l’SDK ufficiale di un altro protocollo e una libreria di lettura PDF più ricca ma più pesante, una regola non scritta ma applicata con costanza, misurare l’albero delle dipendenze prima di accettarlo, non dopo averlo scoperto in produzione.
La seconda decisione
La seconda decisione riguarda cosa succede quando due funzionalità nascono a distanza di tempo ma condividono lo stesso fornitore. Il connettore per Google Calendar esisteva già: stesso progetto Google Cloud, stesso meccanismo di autorizzazione. Anziché duplicare quella logica per Gmail, il team ha estratto la parte generica (come autenticare una richiesta, come riconoscere quando un token è scaduto) in uno strato condiviso, lasciando a ogni singolo connettore solo la conoscenza specifica del proprio servizio. Sembra un dettaglio di igiene del codice, ma ha un risvolto di prodotto concreto: un solo indirizzo di ritorno serve entrambi i servizi, perché Google impone di registrarne uno fisso una volta sola, non uno per funzionalità. Sapere quale dei due servizi si stesse davvero connettendo, in quel punto condiviso, si è rivelato meno banale del previsto: una prima versione cercava di dedurlo a ritroso dal percorso di un file, e si è rotta silenziosamente durante i test automatici, prima ancora di arrivare a un utente vero. La correzione, far dichiarare esplicitamente il proprio nome a ogni servizio invece di indovinarlo, è un piccolo esempio di come l’affidabilità di un sistema si giochi spesso su un dettaglio che nessuna specifica menziona.
La sicurezza
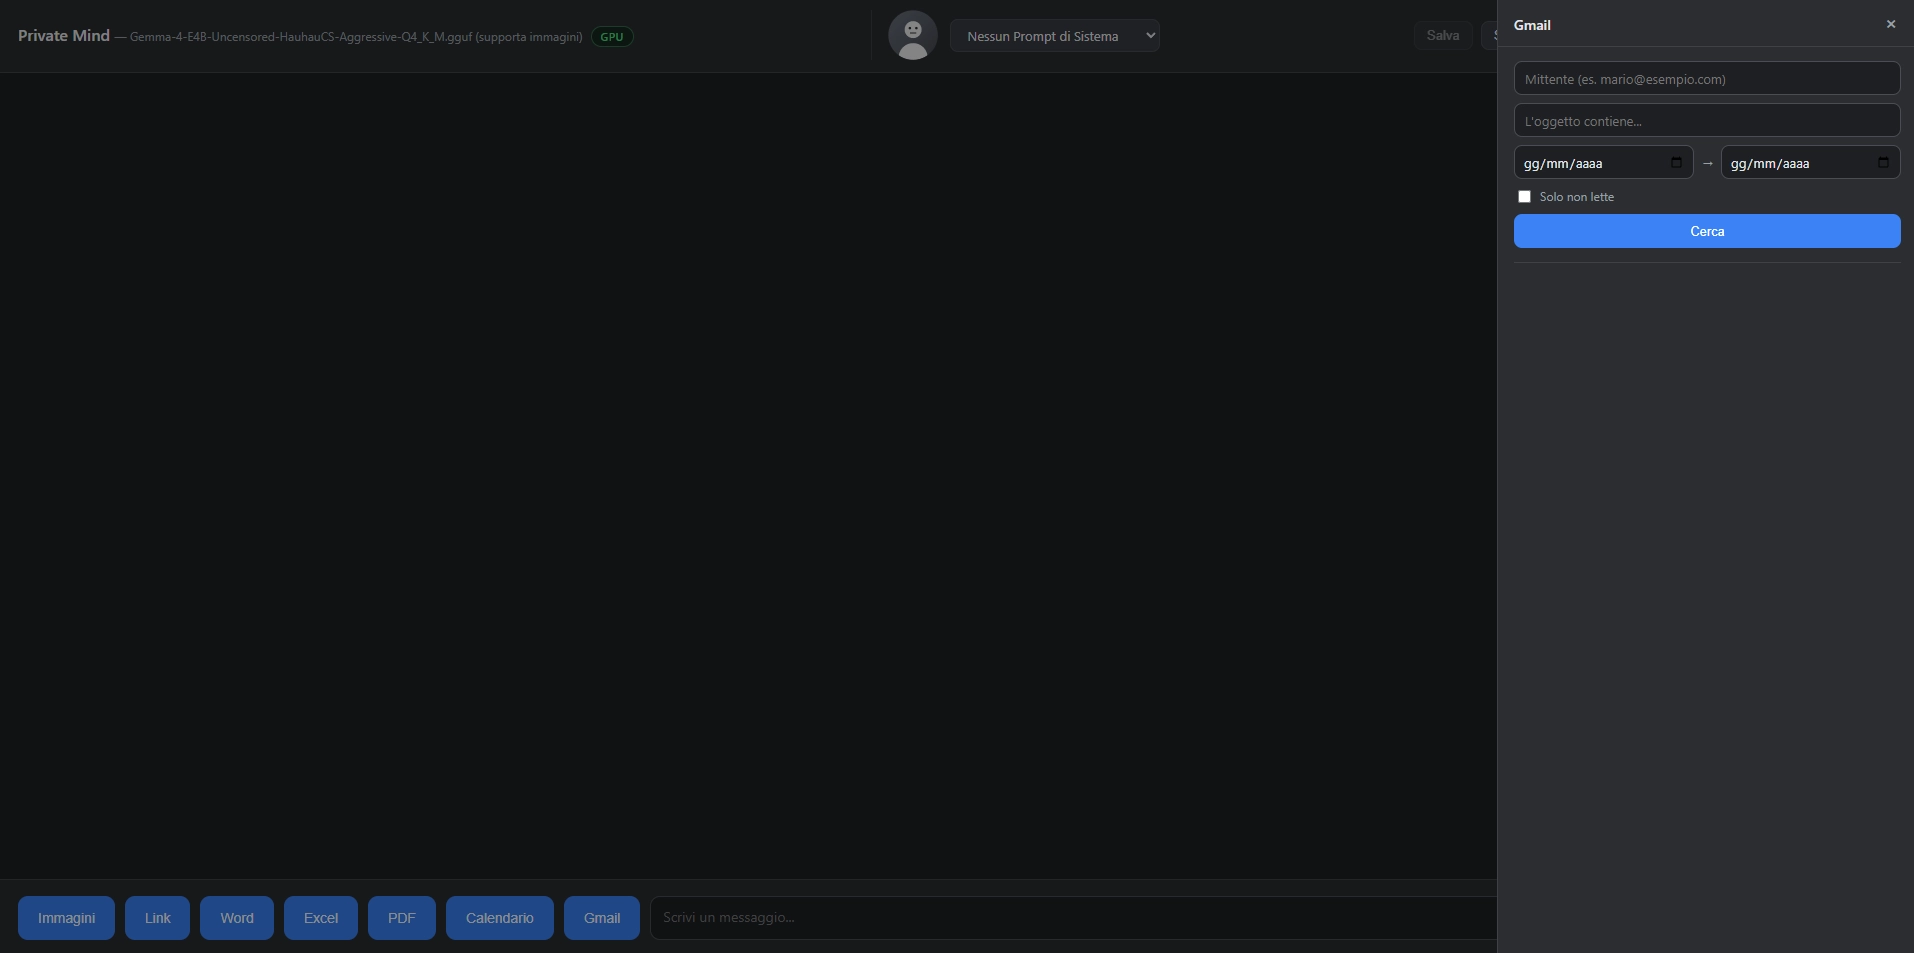
C’è poi la decisione che separa questo lavoro da un’integrazione qualunque: la sicurezza non è affidata al codice, ma al permesso che Google concede. Il connettore chiede l’autorizzazione più ristretta possibile, quella che consente solo di leggere. Non è una promessa scritta in un commento, è un vincolo imposto dal server di Google stesso. Qualunque errore di programmazione, presente o futuro, non potrebbe comunque tradursi in una cancellazione o in un invio di posta, perché quella porta non è mai stata aperta. È una forma di sicurezza che costa poco da implementare e non dipende dalla disciplina di chi scriverà il codice fra un anno, quando magari nessuno ricorderà più perché una certa riga era stata scritta in un modo piuttosto che in un altro.
Responsabilità sul dato
L’ultima scelta è quella con più conseguenze visibili per chi userà il prodotto, ed è anche la più interessante dal punto di vista della responsabilità sul dato. Si sarebbe potuto costruire un riassunto automatico, del tipo “ecco le tue ultime dieci email”, generato in un colpo solo e passato direttamente al modello. Il team ha scelto invece un percorso in due tappe: prima una ricerca che restituisce solo intestazioni (chi scrive, quando, un accenno), poi, solo se l’utente decide deliberatamente di aprirne una, il testo integrale entra nella conversazione. Una ragione tecnica esiste davvero (Gmail non restituisce il contenuto di un messaggio nella stessa chiamata con cui elenca i risultati, quindi un digest automatico moltiplicherebbe le richieste), ma non è quella decisiva. La ragione vera è che nessun contenuto della posta deve arrivare al modello senza che una persona l’abbia visto e scelto per prima. È la stessa filosofia già applicata a una pagina web o a un documento allegato, l’automazione si ferma un passo prima di decidere al posto dell’utente cosa sia rilevante.
Ci serve disciplina
Preso nell’insieme, questo lavoro racconta qualcosa che va oltre Gmail. Un prodotto che fa dell’assenza di connessione la propria ragione d’essere non può trattare un connettore esterno come una voce qualunque in una lista di funzionalità, ogni riga di codice che tocca la rete diventa un punto che qualcuno, prima o poi, dovrà essere pronto a spiegare a un utente diffidente, a chi ne verifica la sicurezza, o a se stesso fra sei mesi. La disciplina non sta nel dire sempre di no a queste funzionalità, ma nel renderle così esplicite nei permessi e così trasparenti nel comportamento da poter essere raccontate in una frase sola senza dover aggiungere una scusa. È un costo che si paga in tempo di sviluppo, e si ripaga ogni volta che qualcuno chiede dove finiscono i propri dati, e la risposta può essere data senza esitazioni.
Se l’articolo ti è piaciuto restiamo in contatto su linkedin a: https://www.linkedin.com/in/andreatonin/
privacy-by-design #oauth2 #dipendenze-software #build-vs-buy #offline-first #superficie-di-attacco #least-privilege #debito-tecnico #architettura-modulare #responsabilita-sul-dato

| Editorial Manager at Pills for Nerds | CTO & Technology Consultant |
Technology professional, editor and lifelong nerd with over 30 years of experience in the digital and innovation sectors. I work as a CTO and technology consultant, designing complex and scalable software ecosystems, and I am also active in IT education and professional training. Alongside my technology career, I serve as Editorial Manager and contributor at Pills for Nerds, online publication covering video games, game development, emerging technologies, artificial intelligence, digital culture and industry events. In my editorial role, I coordinate content planning and contribute articles, interviews, event reports and in-depth features. You can learn more about my consulting work at lucedigitale.com and connect with me on LinkedIn

 By