Immagina di avere un modello linguistico locale di buona qualità, capace di rispondere a domande in tempo reale, ma con un limite che ogni CTO conosce bene: il contesto ha una finestra fissa. Metti che sia 8192 token. Ora prova a caricare un manuale tecnico di 500 pagine e chiedi al modello di rispondere su quello che ha letto. Non hai uno strumento per recuperare “le poche pagine giuste” nel momento della domanda, il modello vedrà l’intero manuale troncato, oppure non lo vedrà affatto.
Questo è il problema che abbiamo affrontato in Private Mind, come permettere a un utente di caricare documenti lunghi e dialogare con il modello basandosi su quel contenuto, senza sprecare il budget di contesto su pagine irrilevanti, e senza aggiungere dipendenze che complicherebbero l’installazione?
Cos’è il RAG
RAG sta per Retrieval-Augmented Generation. Nel termine c’è già la ricetta: si recupera (retrieve) il materiale rilevante, poi lo si passa insieme alla domanda al modello generativo, che produce una risposta (generate) basata su quello. Il colpo di genio non è nuovo, ma la sua applicazione a sistemi offline con risorse limitate lo è.
Per un CTO che gestisce sistemi con contesto limitato, il RAG risponde a una domanda precisa, come posso avere sia breadth (coprire molti documenti) che depth (usare solo ciò che serve)? Senza RAG, scegli uno: o allarghi il contesto (costo e complessità salgono linearmente), o rinunci ai documenti lunghi. Con RAG, il contesto resta costante e quello che cambia è quale pezzo del documento vedi alla volta.
Il vincolo che ci ha guidato
Prima di parlare di design, occorre capire il vincolo. In Private Mind, il contesto totale è 8192 token. Di quei token, una parte va a istoria della conversazione, una al prompt di sistema dell’agente, una alla domanda stessa. Restano circa 3000-3500 token per il “contenuto recuperato” da un documento: è l’1% di un manuale di 500 pagine in media. Non è un bug, è la realtà matematica di un sistema offline.
Un CTO che legge questo si pone subito una domanda: “Se posso usare solo l’1%, come garantisco che il modello recuperi la giusta pagina?“. La risposta è semplice quanto controintuitiva, devo esplicitare questo vincolo al modello stesso. Non è un dettaglio da nascondere nel prompt, è l’architettura della soluzione.
Le tre scelte che definiscono il nostro RAG
Scelta 1: Zero dipendenze aggiuntive. La tentazione più forte nel RAG è ricorrere a ChromaDB, FAISS, o altre librerie di vector search specifiche. Sono ottime, ma portano con sé stack di dipendenze: ChromaDB aggiunge onnxruntime e un’intera architettura asincrona che in un sistema offline diventa overhead. Abbiamo scelto diversamente: numpy (già una dipendenza di llama-cpp-python) e llama.cpp nativo per gli embedding. Con i vettori normalizzati, la ricerca diventa una moltiplicazione matriciale: ~60 MB di vettori, qualche millisecondo di computazione su 20.000 pezzi. Nessuna libreria specializzata, nessuna nuova compilazione.
Scelta 2: Gerarchia a tre livelli. Un documento non entra intero in un indice come blob neutro. Spezziamo in tre livelli: documento (il file caricato), sezione (paragrafo di PDF, foglio di Excel), pezzo (blocco di 1600 caratteri con overlap). La ragione è doppia. Primo: la ricerca avviene sul pezzo (è piccolo, preciso), ma si consegna al modello la sezione intera (ha contesto). Secondo: i PDF e i fogli Excel emettono già marcatori di sezione (## Pagina N, ## Foglio "Costi"), quindi non dobbiamo indovinarli perché sono già lì.
Scelta 3: Due ricerche, non una. Gli embedding capiscono il significato (una parafrasi di “licenziamento” trova “recesso”), ma sbagliano sistematicamente su numeri, codici articolo, nomi proprio, esattamente quello che un CTO cerca. BM25, l’algoritmo a parola-chiave del 1994, trova quelli perfettamente. Abbiamo scelto di correre entrambe le ricerche e fondere i risultati con la Reciprocal Rank Fusion (un metodo che somma i ranghi, non i punteggi, perché i due non sono confrontabili). È più lento di una ricerca sola, ma su 20.000 pezzi significa passare da 0.5ms a 2ms. Accettabile.
Come funziona nel dettaglio
Un utente carica un documento Word di 20 pagine. Il backend legge il file, estrae il testo (con limiti diversi da quelli del chat: è indicizzazione, non risposta), lo spezza in sezioni e pezzi, e lo vettorializza. Questo avviene in un thread separato per non bloccare il server, lo stesso schema già usato nel caricamento del modello. L’interfaccia mostra una barra di avanzamento, il modello di chat resta responsive.
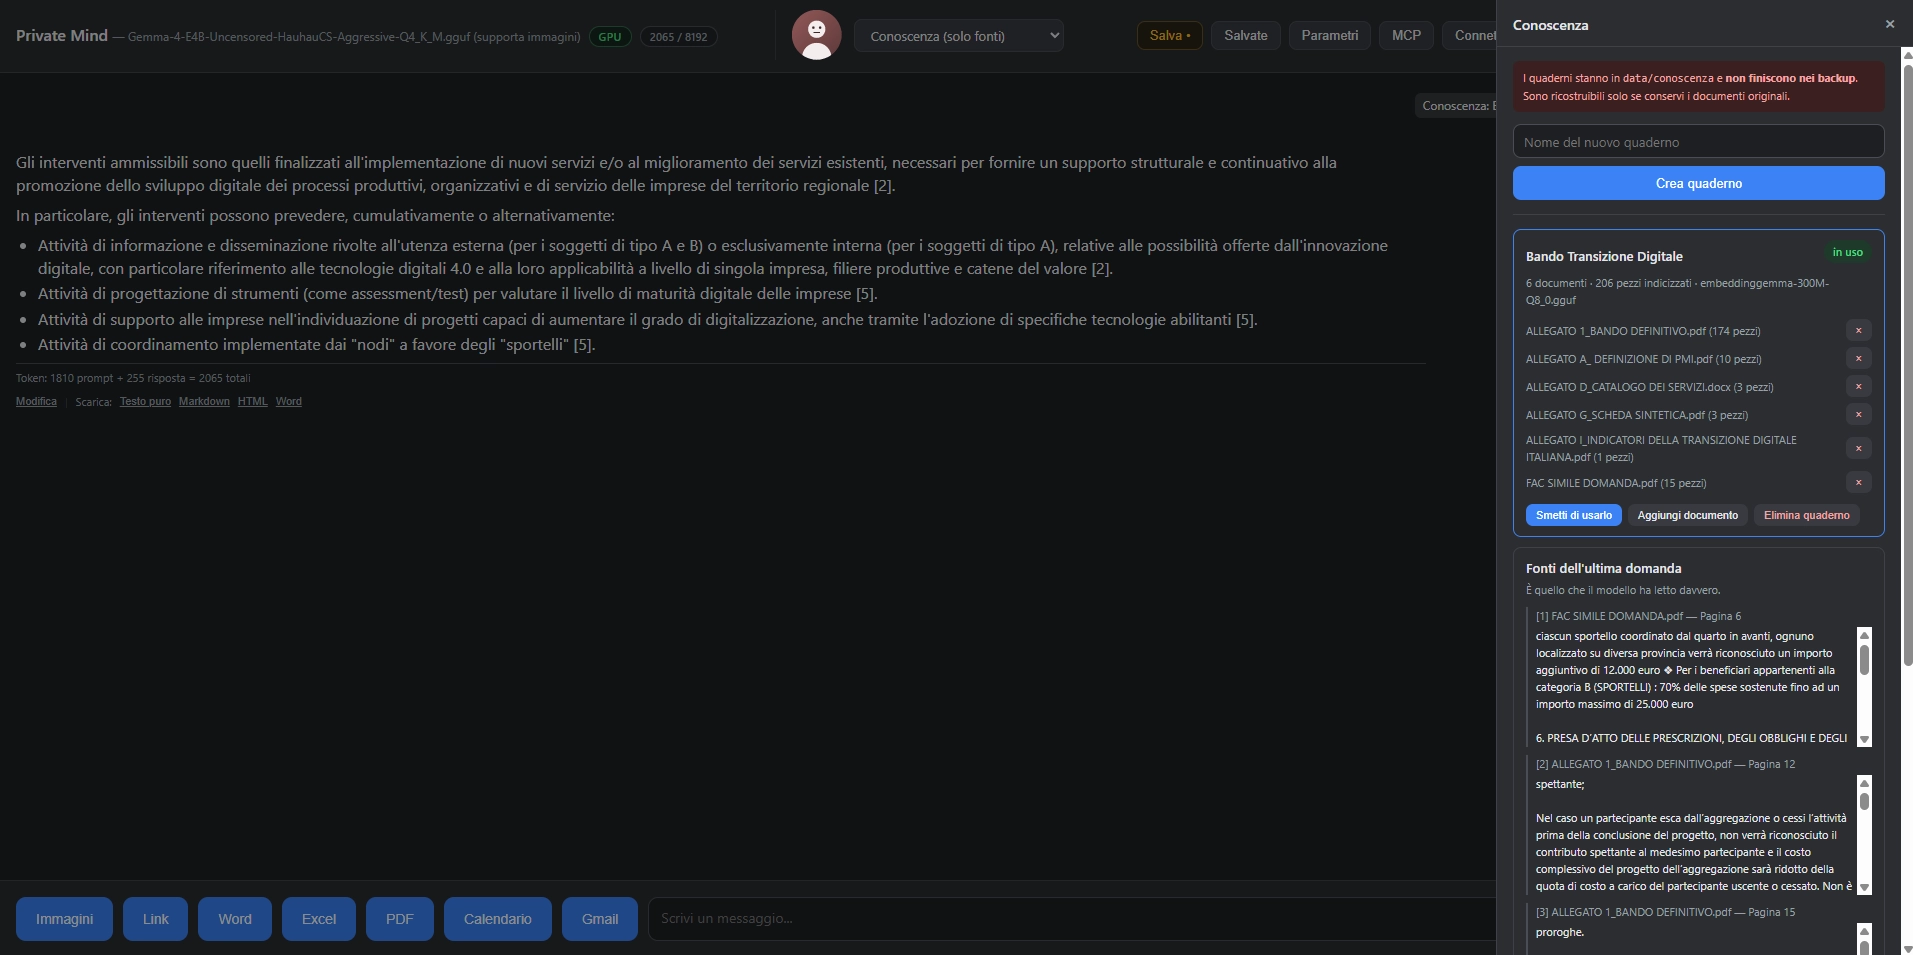
Quando l’utente chiede una domanda, il frontend la manda non solo al modello, ma prima a /api/conoscenza/<id>/cerca con la domanda stessa come query. Il backend recupera cinque o sei pezzi rilevanti dai 20.000 totali, li numera, e li allega al messaggio come “contenuto recuperato”. Il modello vede il tutto: la domanda, i pezzi (contati e numerati: [1] ... [2] ...), e basta.
Una riga della documentazione del backend dichiara il vincolo al modello: “Questo è l’1% di 20.000 pezzi. Non dire che il documento non contiene X se X non è negli estratti che leggi”. È la riga che trasforma il RAG da trucco tecnico a vincolo architetturale conscio.
I limiti
Il RAG non è una soluzione universale, e noi non lo presentiamo così. Ci sono domande che non può fare. Se chiedi “riassumi il documento intero”, il RAG ne recupera l’1%, e il modello può solo dire “non lo trovo negli estratti”, il che è vero. Se chiedi “quante volte ricorre la parola X”, dipende se X ricorre negli estratti scelti. Se X è rara o il recupero sbaglia, la risposta è “non la trovo”, di nuovo vero, non inventato.
Questo è il vantaggio rispetto a modelli più grandi e contesti più ampi: non c’è tentazione di allucinare. Con 8192 token fissi e un budget di recupero conosciuto, il modello sa di che cosa non parla. Un prompt opportunamente disegnato (temperature bassa, citazione obbligatoria, frase di rifiuto letterale con esempio) riduce il rischio di inventare “fonti” che non ha visto.
Perché questa strada
Nel mercato dei RAG ci sono percorsi più battuti. Vedi modelli più grandi (100B+ token di contesto), che costano in GPU e non girano offline. Vedi CloudFlare Vectorize o Pinecone, che spostano la complessità in cloud. Vedi toolkit come LlamaIndex che fanno tutto in una scatola, ma con due dozzine di dipendenze.
Noi abbiamo scelto la via stretta perché il progetto ha un vincolo esplicito: “girare integralmente offline, scarica unzippa e va”. Aggiungere ChromaDB avrebbe significato una nuova estensione compilata nelle ruote. Aggiungere sentence-transformers avrebbe significato torch (200MB+), che toglie spazio a documenti e modelli. Aggiungere cloud avrebbe significato rete e connessioni, che nella mission “tutto locale” è tabù.
La via stretta ha un prezzo: è più lavoro da pensare bene (gerarchia a tre livelli non è ovvio), e costringe a fare scelte esplicite sui compromessi (sì, recuperiamo l’1%, no, non riassumiamo il documento intero). Ma il guadagno è un RAG che il CTO controlla dal primo byte al risultato, senza sorprese nascoste dietro una scatola nera.
Oggi il RAG in Private Mind recupera per ogni messaggio, la domanda arriva, si cercano i pezzi, si allega al modello. Il prossimo passo naturale è la riduzione della storia: il recupero entra nella conversazione turno dopo turno, i pezzi si accumulano nella storia per dare contesto ai turni seguenti. Alzare il MAX_TOKENS della risposta non aiuta (quei token sono tolti dalla conversazione), ma gestire più intelligentemente quale storia conservare di turno in turno sì. È un’altra scelta di design che costringe a farsi domande: cosa conservo, cosa scarto, come ne dichiaro il limite al modello? Non è ovvio, ma è il tipo di domanda che distingue un RAG pensato da uno costruito seguendo un tutorial.
La base di conoscenza oggi è uno strumento di recupero. Domani potrebbe essere molto più di questo, ma solo se i vincoli rimangono espliciti, e le scelte restano consapevoli.
Se l’articolo ti è piaciuto restiamo in contatto su linkedin a: https://www.linkedin.com/in/andreatonin/

| Editorial Manager at Pills for Nerds | CTO & Technology Consultant |
Technology professional, editor and lifelong nerd with over 30 years of experience in the digital and innovation sectors. I work as a CTO and technology consultant, designing complex and scalable software ecosystems, and I am also active in IT education and professional training. Alongside my technology career, I serve as Editorial Manager and contributor at Pills for Nerds, online publication covering video games, game development, emerging technologies, artificial intelligence, digital culture and industry events. In my editorial role, I coordinate content planning and contribute articles, interviews, event reports and in-depth features. You can learn more about my consulting work at lucedigitale.com and connect with me on LinkedIn

 By