Nelle prime tre parti Private Mind è diventata una chat locale funzionante (parte 1),
poi un pacchetto Python con moduli separati (parte 2), poi una chat in cui si sceglie con quale prompt di sistema parlare (parte 3).
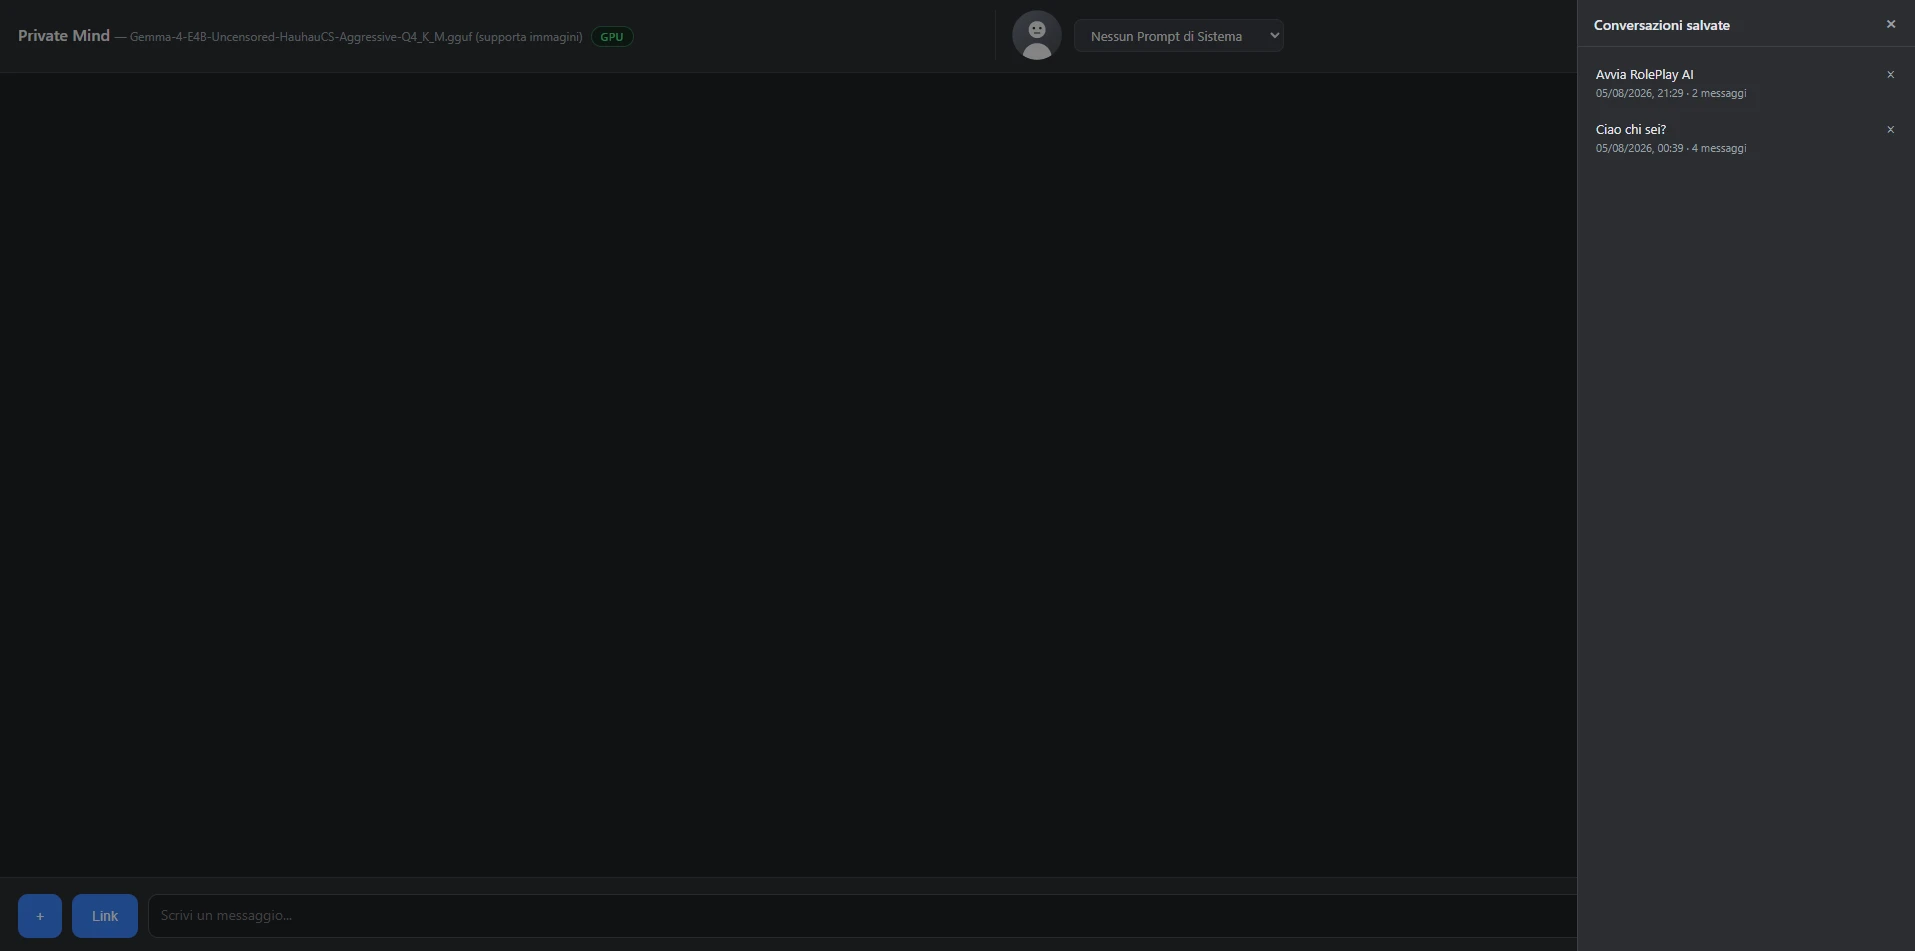
Restava un difetto che rendeva tutto il resto un po’ inutile: le conversazioni vivevano dentro una variabile JavaScript. Un reload distratto e sparivano. Chiudere il browser e sparivano. Ci si può convivere finché si chiedono conversioni di unità di misura; non si può convivere quando hai appena passato quaranta minuti a costruire un’analisi con l’agente Red Team.
Questa quarta parte racconta come ho aggiunto il salvataggio. Il codice è banal, è JSON su disco, non c’è nessuna magia, ma le decisioni intorno al codice sono la parte che vale la pena raccontare: dove mettere le immagini, perché non c’è un index.json, perché il nome del file non è il titolo, e come si evita che una richiesta HTTP fatta apposta si legga le mie chiavi API.
Prima il documento, poi il codice
Nel progetto ho due file di lavoro. docs/wishlist.md è dove parcheggio le idee nel momento in cui vengono in mente, senza interrompere quello che sto facendo. Quando un’idea è matura, diventa una richiesta scritta in docs/richieste/NNN_nome.md: comportamento attuale, comportamento desiderato, vincoli, come si verifica. Solo a quel punto si scrive il codice.
Una voce di wish list è un promemoria; una richiesta è una specifica.
Il salvataggio delle conversazioni è stata la prima voce a fare quel percorso (docs/richieste/001_salvataggio_conversazioni.md), e mi ha convinto della convenzione. In wish list la voce era una riga con tre domande aperte: dove salvare, in che formato, cosa fare delle immagini. Rispondere a quelle tre domande prima di aprire l’editor ha prodotto un’implementazione che non ho dovuto rifare, e cosa che conta di più quando si lavora con un assistente di codice, un documento con cui allineare l’agente, invece di spiegare a voce ogni volta perché una scelta è quella.
Le quattro decisioni
- Le immagini stanno fuori dal JSON, come file veri decodificati. I file di chat restano piccoli e leggibili; costa una conversione in entrata e una in uscita.
data/è fuori dal backup. Conseguenza da mettere in chiaro: le conversazioni diventano l’unica cosa del progetto che non è né ri-ottenibile né protetta. Il codice sta negli zip, i.ggufsi riscaricano, le chat no.- Il salvataggio è esplicito, con un pulsante. Niente autosave: la cartella non si riempie di prove da tre battute. In cambio, una conversazione non salvata si perde al reload, quindi il pulsante deve urlare che ci sono modifiche non salvate.
- La cancellazione è definitiva, nessun cestino. Il
DELETErimuove il JSON e la cartella delle immagini. Va chiesta conferma, perché per il punto 2 non c’è nessun backup da cui ripescare.
Le scrivo con le conseguenze attaccate perché è così che le ho scritte nel
documento. Una decisione senza il suo prezzo dichiarato è una decisione che fra
sei mesi sembrerà solo una svista.
Niente database, niente indice
La struttura su disco è questa:
📂 data                       ← accanto all'eseguibile, come models/ e agents/
 ┣ 📂 chats
 ┃ ┣ 📜 20260805-143210.json
 ┃ ┗ 📜 20260805-151002.json
 ┗ 📂 media
   ┗ 📂 20260805-143210
     ┣ 🖼 01.png
┗ 🖼 02.jpgUn file per conversazione, stesso idioma già usato per gli agenti: un salvataggio riscrive solo la sua conversazione, un JSON corrotto ne perde una sola, e cancellare è rimuovere un file. SQLite sarebbe stato legittimo, ma avrebbe aggiunto uno schema da far evolvere e un file binario opaco, per un carico di lavoro che è “una manciata di documenti letti per intero”. Più interessante è la cosa che non c’è: un index.json con l’elenco delle conversazioni. L’elenco si ricava leggendo la cartella.
def elenca_chat() -> list:
    """Metadati di tutte le conversazioni, dalla piu' recente. Senza `messages`.

    L'elenco si deriva dalla cartella invece che da un indice: un indice e'
    una seconda copia della verita' che si disallinea appena si cancella un
    file a mano.
"""Un indice è una seconda copia della verità. Il progetto aveva già pagato quella lezione con le immagini degli agenti, che esistono in due copie perché su Windows non potevo fare un link simbolico senza privilegi di amministratore: da allora, quando posso derivare invece di duplicare, derivo. Se un giorno le chat fossero migliaia, un indice si potrà aggiungere ma come cache ricostruibile, mai come fonte.
Nota di robustezza che si vede solo quando serve: un file rotto non deve
rendere illeggibile tutto l’elenco.
try:
    dati = carica_chat(chat_id)
except (ChatNotFoundError, ChatStorageError):
    # Un singolo file rotto non deve rendere illeggibile tutto
    # l'elenco: sparisce quella voce, le altre restano.
continueNessun formato interno
{
  "id": "20260805-143210",
  "title": "Analisi del contratto di fornitura",
  "agentId": "red-team",
  "created": "2026-08-05T14:32:10",
  "updated": "2026-08-05T15:04:55",
  "messages": [ ... ]
}Il campo messages è identico all’array che /api/chat già riceve e che il frontend già tiene in memoria. Ricaricare una conversazione è assegnare quell’array e ridisegnare: nessun livello di conversione da mantenere allineato. È la decisione che ha reso l’intera funzionalità piccola. Ogni volta che si introduce un “formato di persistenza” diverso dal “formato di runtime”, si firma un impegno a tenerli d’accordo per sempre e prima o poi non lo si mantiene.
agentId c’è per il motivo raccontato nella parte 3: riaprire una chat Red
Team con RolePlay attivo darebbe un seguito incoerente senza che si capisca
perché.
L’id lo assegna il server, e non è il titolo
L’id è AAAAMMGG-HHMMSS: ordina cronologicamente da solo, senza campi
aggiuntivi da leggere.
def nuovo_id(adesso: datetime | None = None) -> str:
    """Id nuovo, nel formato AAAAMMGG-HHMMSS.

    Lo assegna il server e mai il client, cosi' il client non compone mai un
    nome di file. Due salvataggi nello stesso secondo sono improbabili con un
    pulsante, ma se capita si scala di un secondo invece di sovrascrivere.
"""Due punti, entrambi imparati a spese altrui:
Il client non inventa mai un nome di file. Se l’id lo proponesse il browser, ogni route dovrebbe difendersi da un id ostile in un posto diverso. Assegnandolo il server, la superficie si riduce a una funzione sola.
Il titolo non entra nel nome del file. I titoli sono generati dai primi ~50 caratteri del primo messaggio dell’utente e si possono modificare a mano: prima o poi uno contiene un : o un ?, che il filesystem di Windows rifiuta. Il titolo sta dentro il JSON, dove può contenere quello che vuole.
La riga di codice che protegge le chiavi API
Questa è la parte da non sbagliare. L’id arriva dal client, dentro l’URL, e diventa un nome di file. Sopra data/ c’è setup.json, che è dove il progetto tiene le chiavi API.
Senza validazione, GET /api/chats/../../setup.json è una richiesta perfettamente valida che legge un file che non deve uscire da quella macchina.
ID_RE = re.compile(r"^\d{8}-\d{6}$")
MEDIA_NAME_RE = re.compile(r"^\d{2,6}\.(?:png|jpg|jpeg|webp|gif)$")


def _valida_id(chat_id) -> str:
    # Un id malformato e' trattato come "non trovato" e non come "richiesta
    # sbagliata": a chi prova un traversal non serve sapere che differenza c'e'.
    if not isinstance(chat_id, str) or not ID_RE.match(chat_id):
        raise ChatNotFoundError(f"Id conversazione non valido: {chat_id!r}")
return chat_idTre dettagli che rendono questo controllo diverso da un controllo per finta:
- Lista bianca, non lista nera. Non si cerca
..da rifiutare: si accettasoltanto ciò che corrisponde esattamente al pattern. Le liste nere di traversal si aggirano da trent’anni (..%2F, backslash, doppie codifiche); una regex che accetta solo otto cifre, un trattino e sei cifre no. - La validazione avviene prima di comporre il percorso, non dopo.
os.path.joincon un..dentro collabora molto volentieri. - Un id malformato è un 404, non un 400. Chi sta provando un traversal non ha bisogno di sapere se ha sbagliato formato o se il file non c’era.
Il progetto gira su 127.0.0.1 e non è esposto a Internet, quindi lo scenario è remoto. Ma “gira solo in locale” è esattamente il tipo di premessa che decade il giorno in cui si aggiunge una funzione di condivisione, e a quel punto nessuno torna a rivedere la validazione degli id.
Le immagini: dentro base64, fuori file veri
Nel frontend un’immagine allegata è una data URL base64 tenuta in memoria. Scriverla così nel JSON avrebbe prodotto file da megabyte, illeggibili con un editor di testo. Quindi in salvataggio il backend le estrae, le scrive come file veri e lascia nel JSON solo un riferimento:
{"type": "image_url", "image_url": {"url": "/api/media/20260805-143210/01.png"}}Il "type": "image_url" resta invariato, e non è estetica: has_image() e count_images() — le funzioni che rifiutano le immagini sui modelli senza visione e che contano i token nella potatura — continuano a funzionare su una conversazione ricaricata senza sapere niente di tutto questo. Cambiare quel type in qualcosa tipo "saved_image" avrebbe rotto due funzionalità lontane, in silenzio, e mesi dopo.
Quattro regole nella scrittura:
- Lista bianca dei mime (
png,jpeg,webp,gif), estensione dedotta dal mime dichiarato nella data URL. Qualunque altro mime viene rifiutato: il nome del file su disco non deve mai derivare da una stringa arbitraria del
client. - Numerazione progressiva; ri-salvando una conversazione, le immagini già su disco tengono il loro riferimento e le nuove partono da
max esistente + 1. - Prima i media, poi il JSON.
- Pulizia degli orfani dopo un salvataggio riuscito: la funzione “Modifica” permette di cancellare un messaggio, e senza pulizia le immagini dei messaggi rimossi resterebbero su disco per sempre, invisibili.
Nel senso opposto, quando una conversazione ricaricata prosegue, i riferimenti
vanno ri-gonfiati in data URL: il modello vuole i byte, non un percorso.
I test
54 test nuovi, nessuno dei quali carica il modello. Quelli che considero irrinunciabili:
- l’id fuori formato è rifiutato (gli undici casi visti sopra) e nessun file fuori da
data/viene toccato; - dopo un salvataggio con immagini, nel JSON non compare mai la stringa
data:— è il modo diretto di verificare che il backend estrae davvero le immagini, qualunque cosa mandi il client; - il giro completo salva → rileggi restituisce
messagesidentico; - il ri-gonfiaggio restituisce data URL uguali alle originali;
- ri-salvando, le immagini esistenti tengono il loro numero, le nuove proseguono, quelle non più citate spariscono;
- l’elenco è ordinato dal più recente e non contiene
messages; - la scrittura atomica non lascia in giro file
.tmp; - e uno che sembra fuori posto:
should_include()dibackup_locale.pyesclude davverodata/. È una decisione di prodotto congelata in un test, perché è esattamente il tipo di cosa che qualcuno “sistema” per sbaglio.
Riassumendo
- Prima la richiesta scritta, poi il codice. Le tre domande aperte (dove, in che formato, e le immagini) risolte su carta hanno prodotto un’implementazione che non ho dovuto rifare.
- Un file JSON per conversazione, nessun indice: l’elenco si deriva dalla cartella, perché un indice è una seconda copia della verità.
- Il formato salvato è il formato di runtime: nessuna conversione da tenere allineata.
- L’id lo assegna il server ed è validato con una lista bianca prima di comporre qualunque percorso — sopra
data/ci sono le chiavi API. - Le immagini fuori dal JSON, scritte prima del JSON, con pulizia degli orfani; e il frontend adotta i messaggi normalizzati che il server restituisce, altrimenti ogni salvataggio duplica tutto.
- Scrittura atomica, perché un salvataggio interrotto distruggerebbe la versione precedente e non c’è backup.
Nessuna di queste è un’idea brillante. Sono tutte decisioni piccole, prese guardando cosa succede quando qualcosa va storto invece di cosa succede quando va tutto bene che, ho scoperto, è la differenza fra una funzionalità che
funziona sul mio computer e una che funzionerà anche fra sei mesi.
Se l’articolo ti è piaciuto restiamo in contatto su LinkedIn: https://www.linkedin.com/in/andreatonin/

| Editorial Manager at Pills for Nerds | CTO & Technology Consultant |
Technology professional, editor and lifelong nerd with over 30 years of experience in the digital and innovation sectors. I work as a CTO and technology consultant, designing complex and scalable software ecosystems, and I am also active in IT education and professional training. Alongside my technology career, I serve as Editorial Manager and contributor at Pills for Nerds, online publication covering video games, game development, emerging technologies, artificial intelligence, digital culture and industry events. In my editorial role, I coordinate content planning and contribute articles, interviews, event reports and in-depth features. You can learn more about my consulting work at lucedigitale.com and connect with me on LinkedIn

 By